监控告警
目录
一、功能概述
监控告警是 ESB 平台核心运维工具,通过实时监测系统运行状态、资源使用及业务处理流程,及时发现并处理异常,保障系统稳定运行。该功能涵盖主机监控、集群监控、流程集成监控和异常重试管理等多个维度,采用分层架构:数据采集层负责数据收集,数据传输层保障数据送达监控平台,数据处理层进行深度分析,告警触发层在异常发生时及时展示告警信息。
二、功能操作指南
(一)监控概览
监控概览专注于系统运行状态的全面监控,集成告警统计概览、后端服务器状态监测、慢 API 列表展示、响应码占比统计及 API 调用失败率 TOP10 分析等功能模块。此界面为系统运维人员提供统一视图,便于集中获取系统告警信息。通过该界面,运维人员能够高效评估系统当前健康状态,精准定位潜在问题,并迅速采取针对性措施,确保系统稳定、高效运行。
操作步骤:登录管理中心,在左侧导航菜单选择 "监控告警" ,默认进入 "监控概览" 标签页。
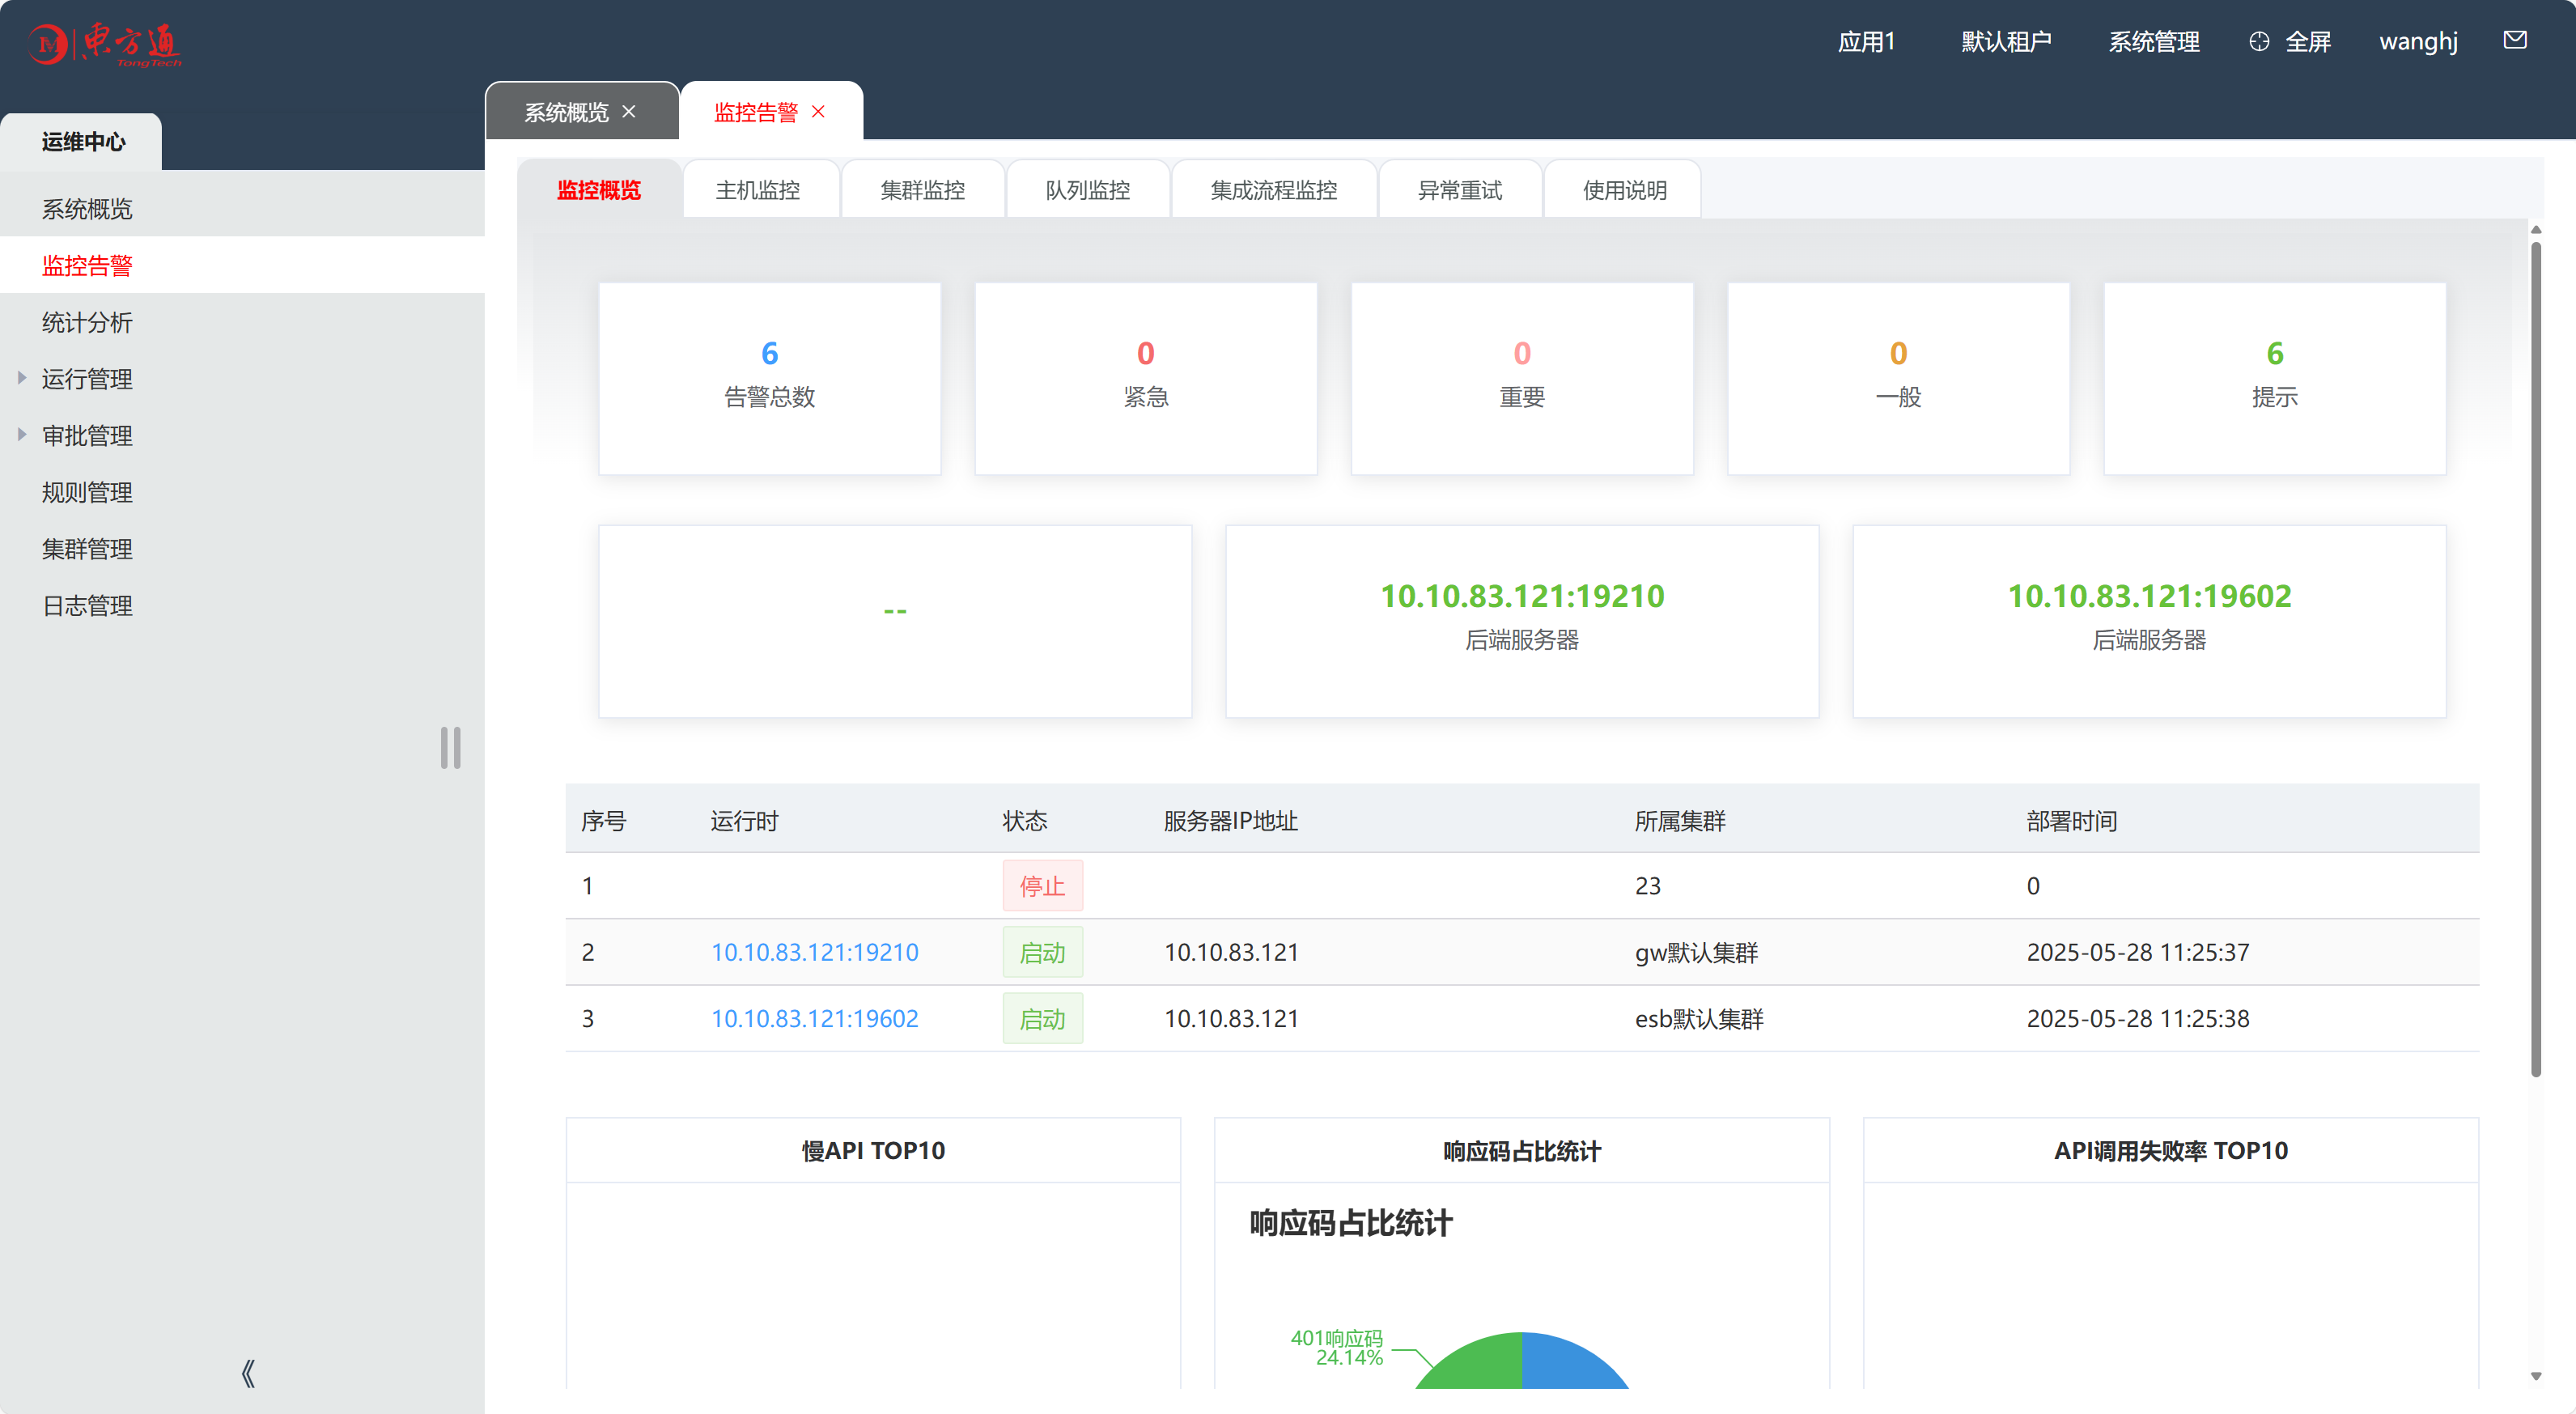
页面内容详解
-
告警统计卡片:直观呈现告警总数,以及紧急、重要、一般和提示告警的具体数量。
-
后端服务器状态:展示各服务器的运行时状态、IP 地址、所属集群及部署时间。具体定义如下:
| 字段 | 说明 |
|---|---|
| 运行时状态 | 表示服务器当前是否可正常响应请求,取值为 "启动" 或 "停止" |
| 服务器 IP 地址 | 服务器的网络地址,分为公网 IP(对外服务)和内网 IP(集群内部通信) |
| 所属集群 | 服务器所属的集群名称,用于资源分组与管理 |
| 部署时间 | 服务器实例的启动或配置更新时间 |
-
慢 API TOP10:展示系统中响应时间最长的 10 个 API,按照响应时间从高到低排序,方便您快速定位可能影响系统性能的慢 API。通过分析慢 API 的业务逻辑、调用频率以及涉及的资源,您可以针对性地进行优化,例如优化代码逻辑、增加缓存机制或调整资源分配,从而提升系统整体响应速度。
-
响应码占比统计:以饼图形式呈现各类响应码占比。其中,2xx 系列表示成功响应(200 为成功);3xx 系列为重定向响应;4xx 系列是客户端错误(如 404 表示资源不存在);5xx 系列为服务器错误(500 表示服务器内部错误)。
-
API 调用失败率 TOP10:系统将自动筛选并列出调用失败率最高的 10 个 API。通过这一数据呈现,您可以快速定位到问题频发的关键 API,进而针对这些 API 展开深入排查,例如检查接口参数设置、网络连接状况、服务器负载等,精准解决 API 调用异常问题。点击告警信息,可查看详细内容,获取更多故障细节。
(二)主机监控
主机监控对系统内各主机运行状态进行 7×24 小时实时监测,通过采集 CPU 使用率、内存占用率、磁盘 I/O 速率及网络流量等关键指标,以图表和报表形式呈现,帮助运维人员及时发现并处理主机异常。
操作步骤:在左侧导航栏点击 "监控告警" ,顶部导航栏点击 "主机监控" 进入页面;选择需监控的主机 IP 地址,并可自定义 "近 1 小时""近 6 小时""近 12 小时""近 24 小时" 等时间范围,查看对应时间内的性能指标数据。
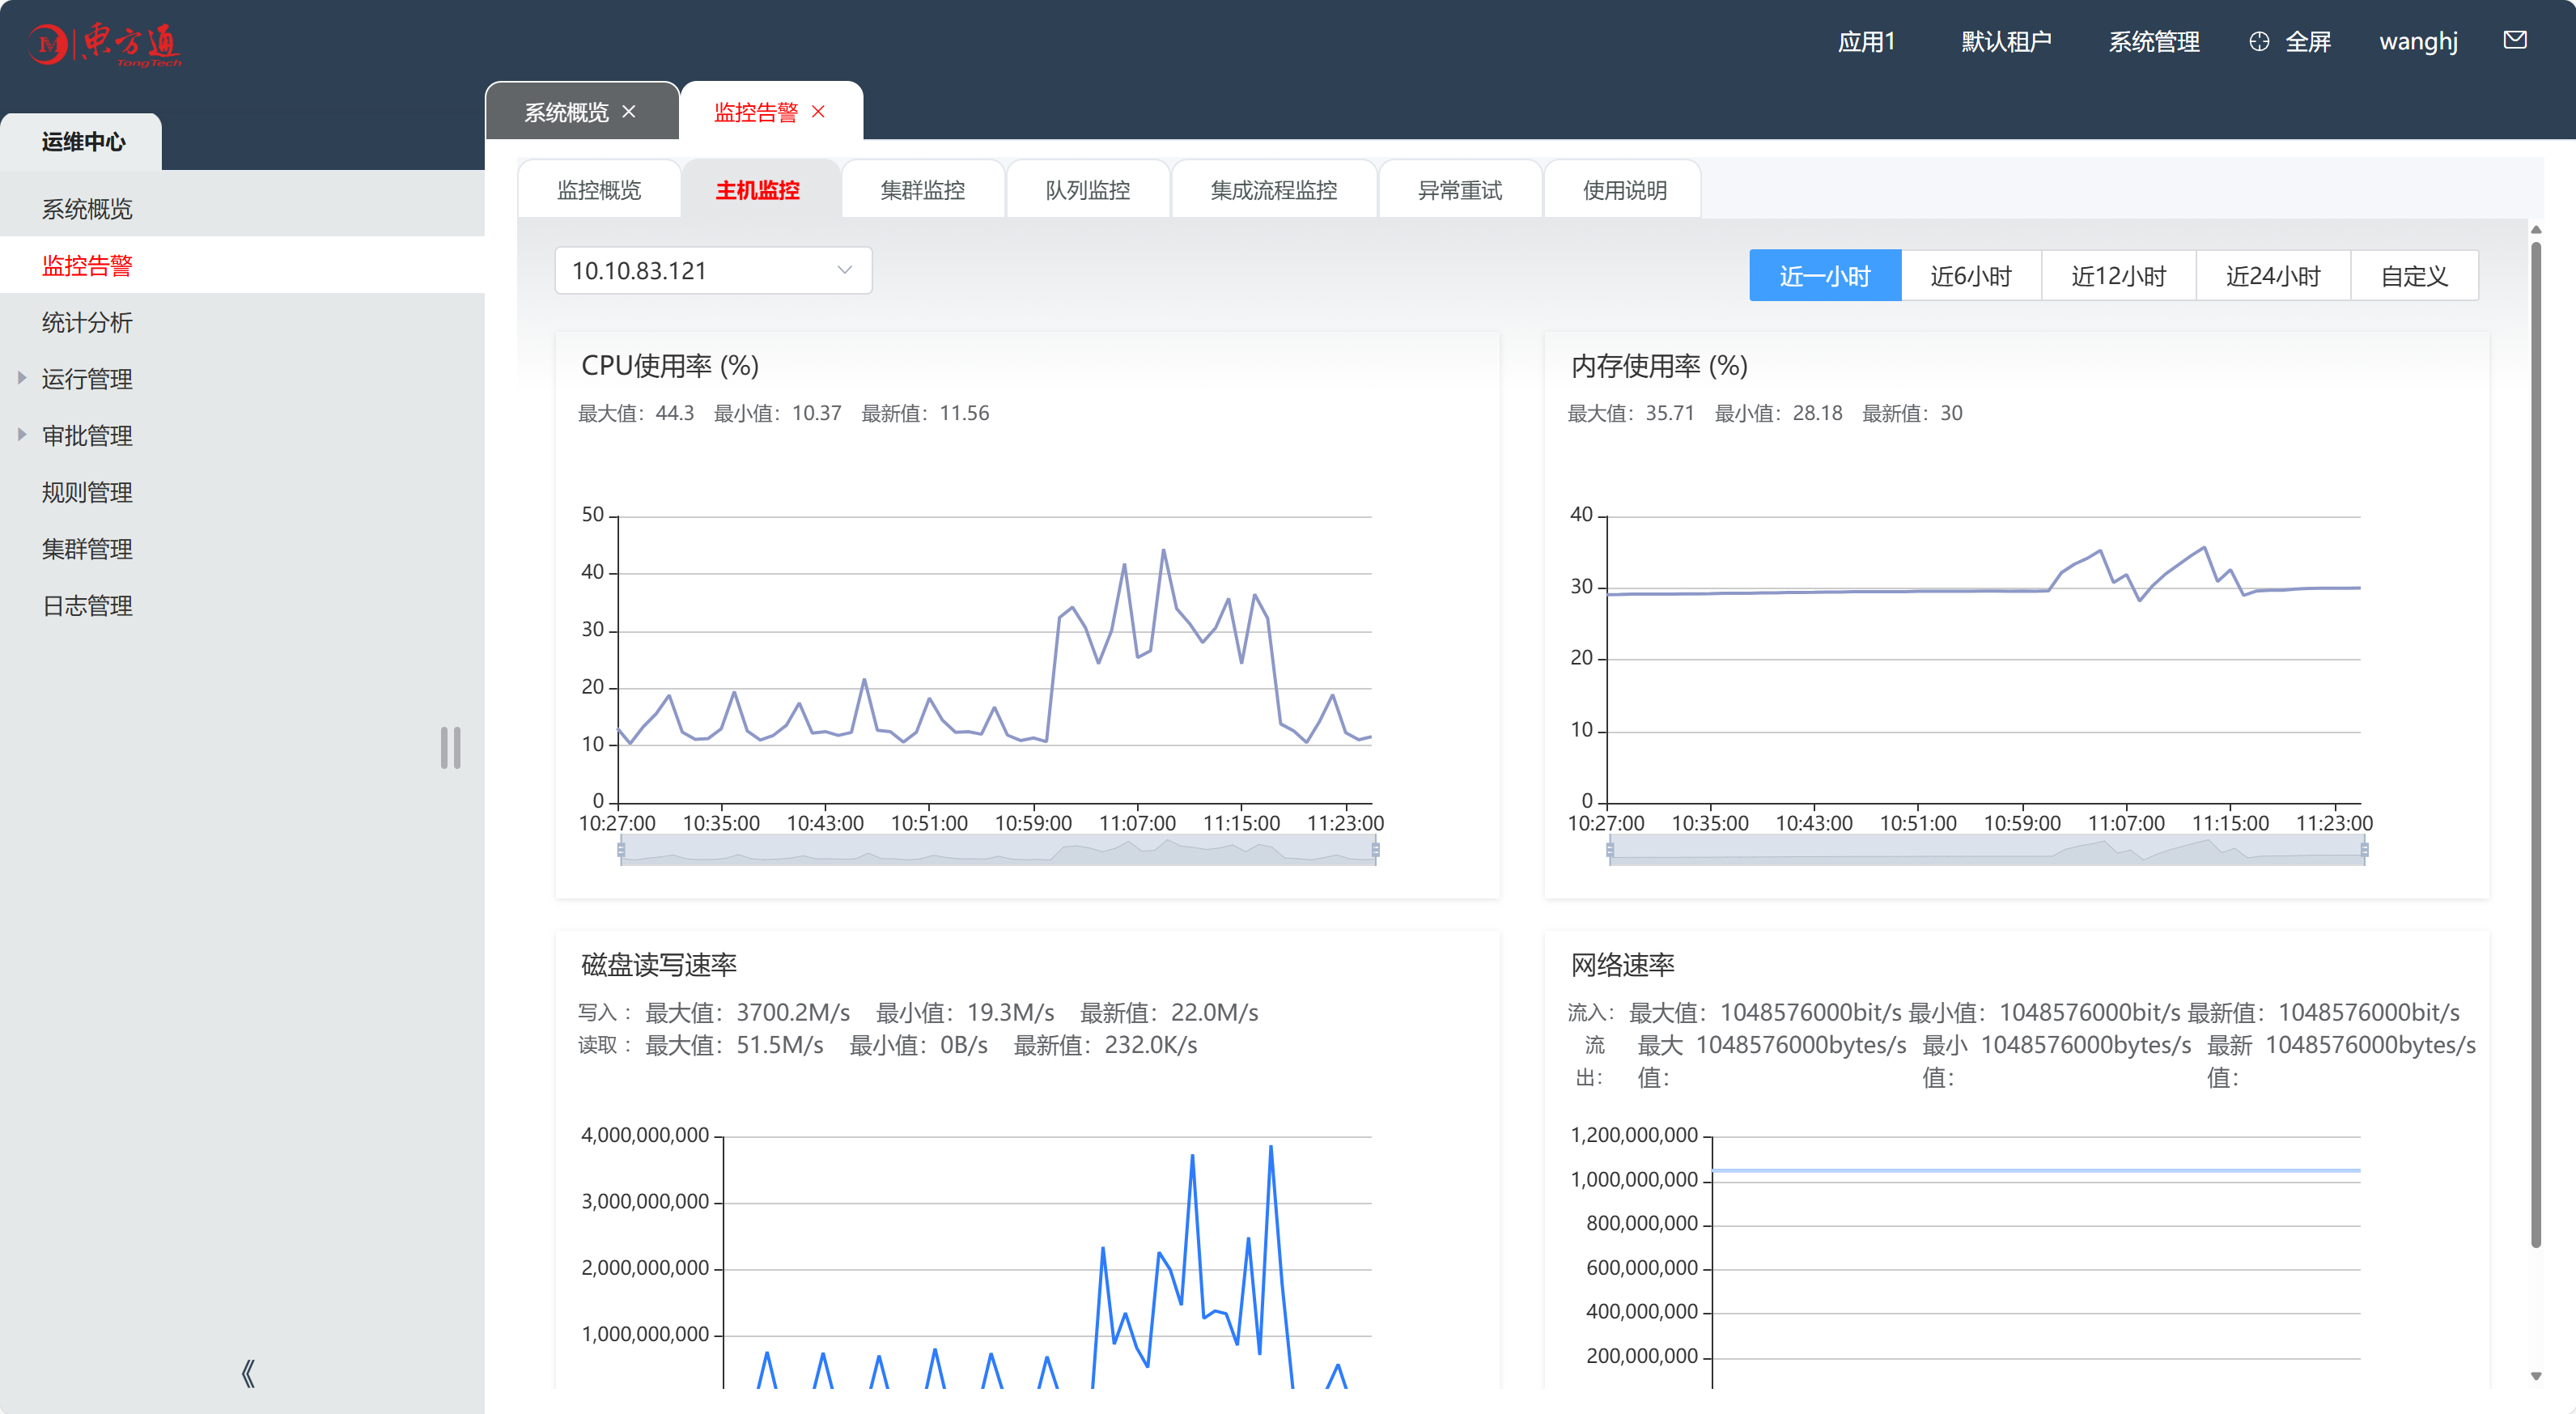
性能指标图表解读
-
CPU 使用率(%):展示实时趋势及最大值、最小值、最新值。正常低于 70%,70%-85% 为警戒区间需密切关注,持续高于 85% 可能存在性能瓶颈。同时留意周期性峰值和持续上升趋势,必要时分析并优化占用高资源进程。
-
内存使用率(%):呈现实时趋势及关键数值。正常应低于 80%,80%-90% 需关注,高于 90% 可能影响系统性能。若内存使用稳定增长或大幅波动,需排查内存泄漏或大对象操作问题。
-
磁盘读写速率:量化磁盘读写速度,包括写入和读取速率的最大值、最小值和最新值。超出正常范围可能因大规模数据操作导致系统性能下降,需定位相关进程并优化。
-
网络速率:展示网络收发包速率实时趋势及关键值。需关注带宽利用率、异常流量峰值、高数据包错误率和高连接数,及时处理网络质量问题或潜在攻击。
(三)集群监控
集群监控用于实时掌握系统各集群运行状态,通过分析节点资源使用、任务分配和数据同步等指标,保障集群稳定运行和业务连续性。
操作步骤:在左侧导航栏选择 "监控告警" ,顶部导航栏选择 "集群监控" 进入页面。
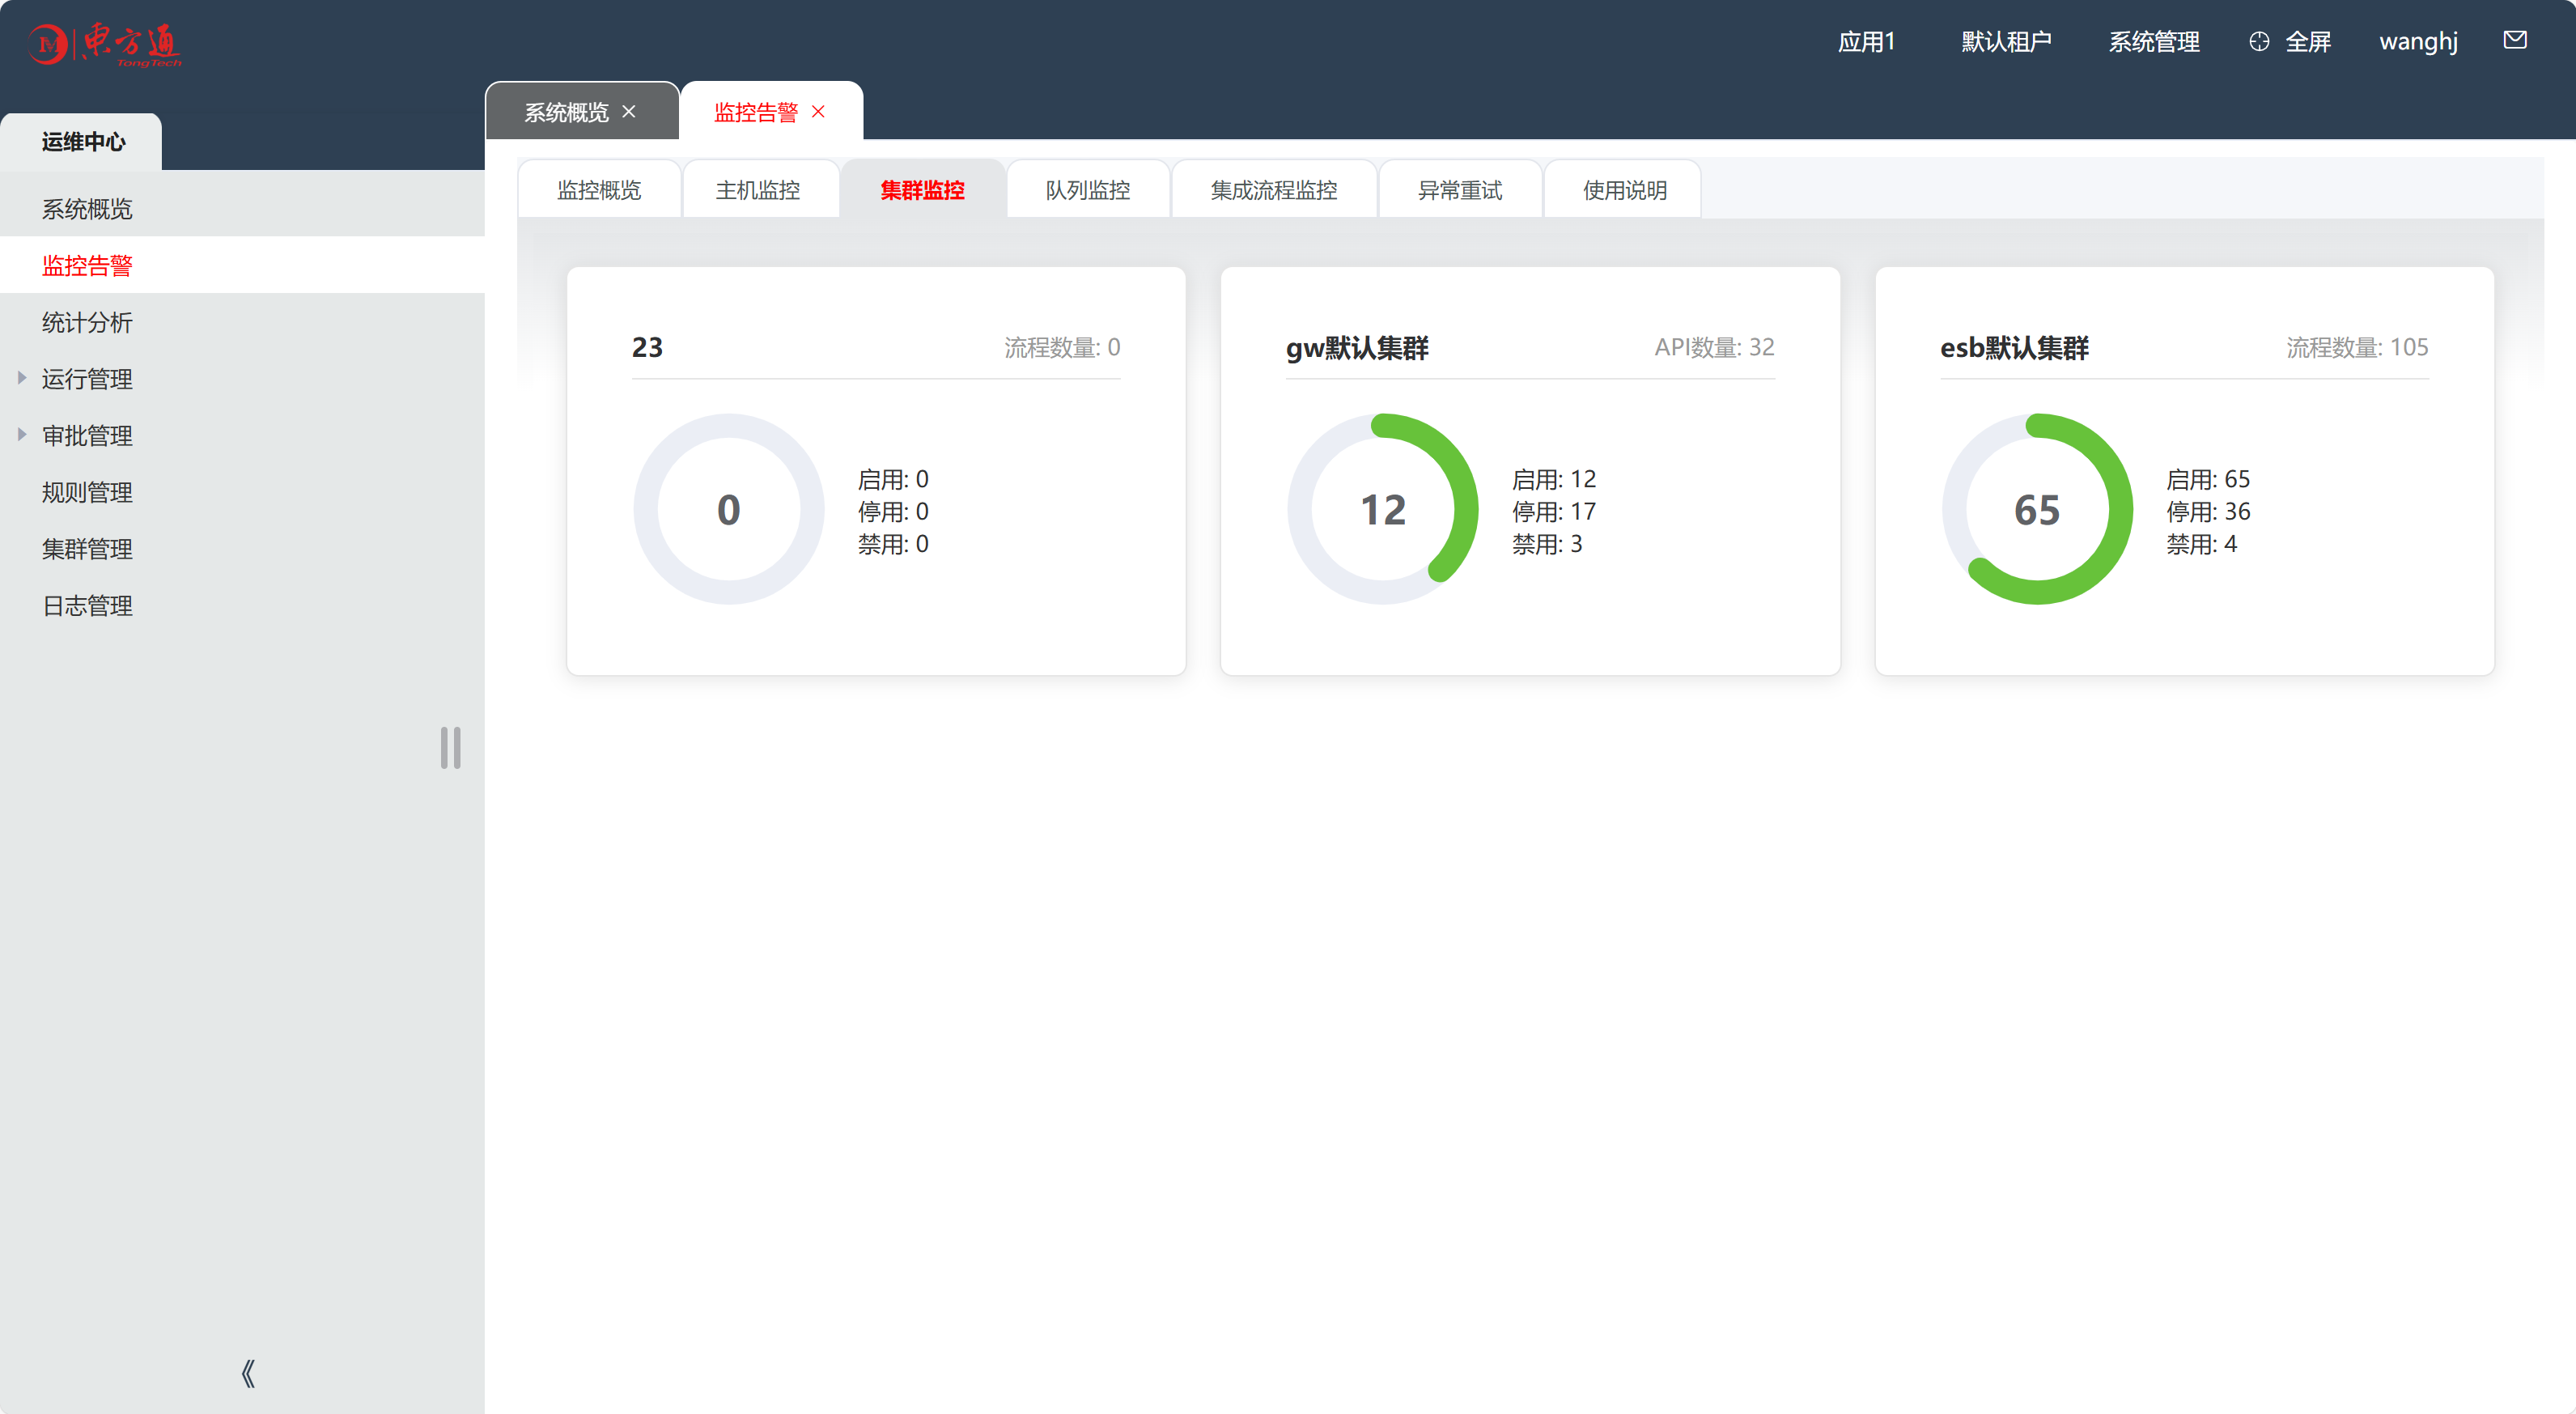
页面内容介绍:采用卡片视图展示系统 API 网关 与 ESB 的所有集群,卡片包含集群名称、集成流数量、运行时状态(环形进度条展示)和状态详情(已启动和未启动集成流数量);同时通过饼图可视化展示集群运行时状态分布。
(四)队列监控
队列监控用于实时监测系统中消息队列的运行状态,通过采集队列的生产者数量、消费者数量、消息处理情况 等关键指标,保障消息传递的稳定性和可靠性。
操作步骤:在左侧导航栏选择 "监控告警" ,顶部导航栏点击 "队列监控" 进入主页面;该模块包含 "消息队列"、"生产者"、"消费者" 三个子页面,可通过顶部标签页切换查看不同维度的队列运行数据。
页面数据展示
- 消息队列:展示队列名称、地址、类型、生产者 、消费者数量、消息处理状态等核心指标,用于监控队列整体运行情况。
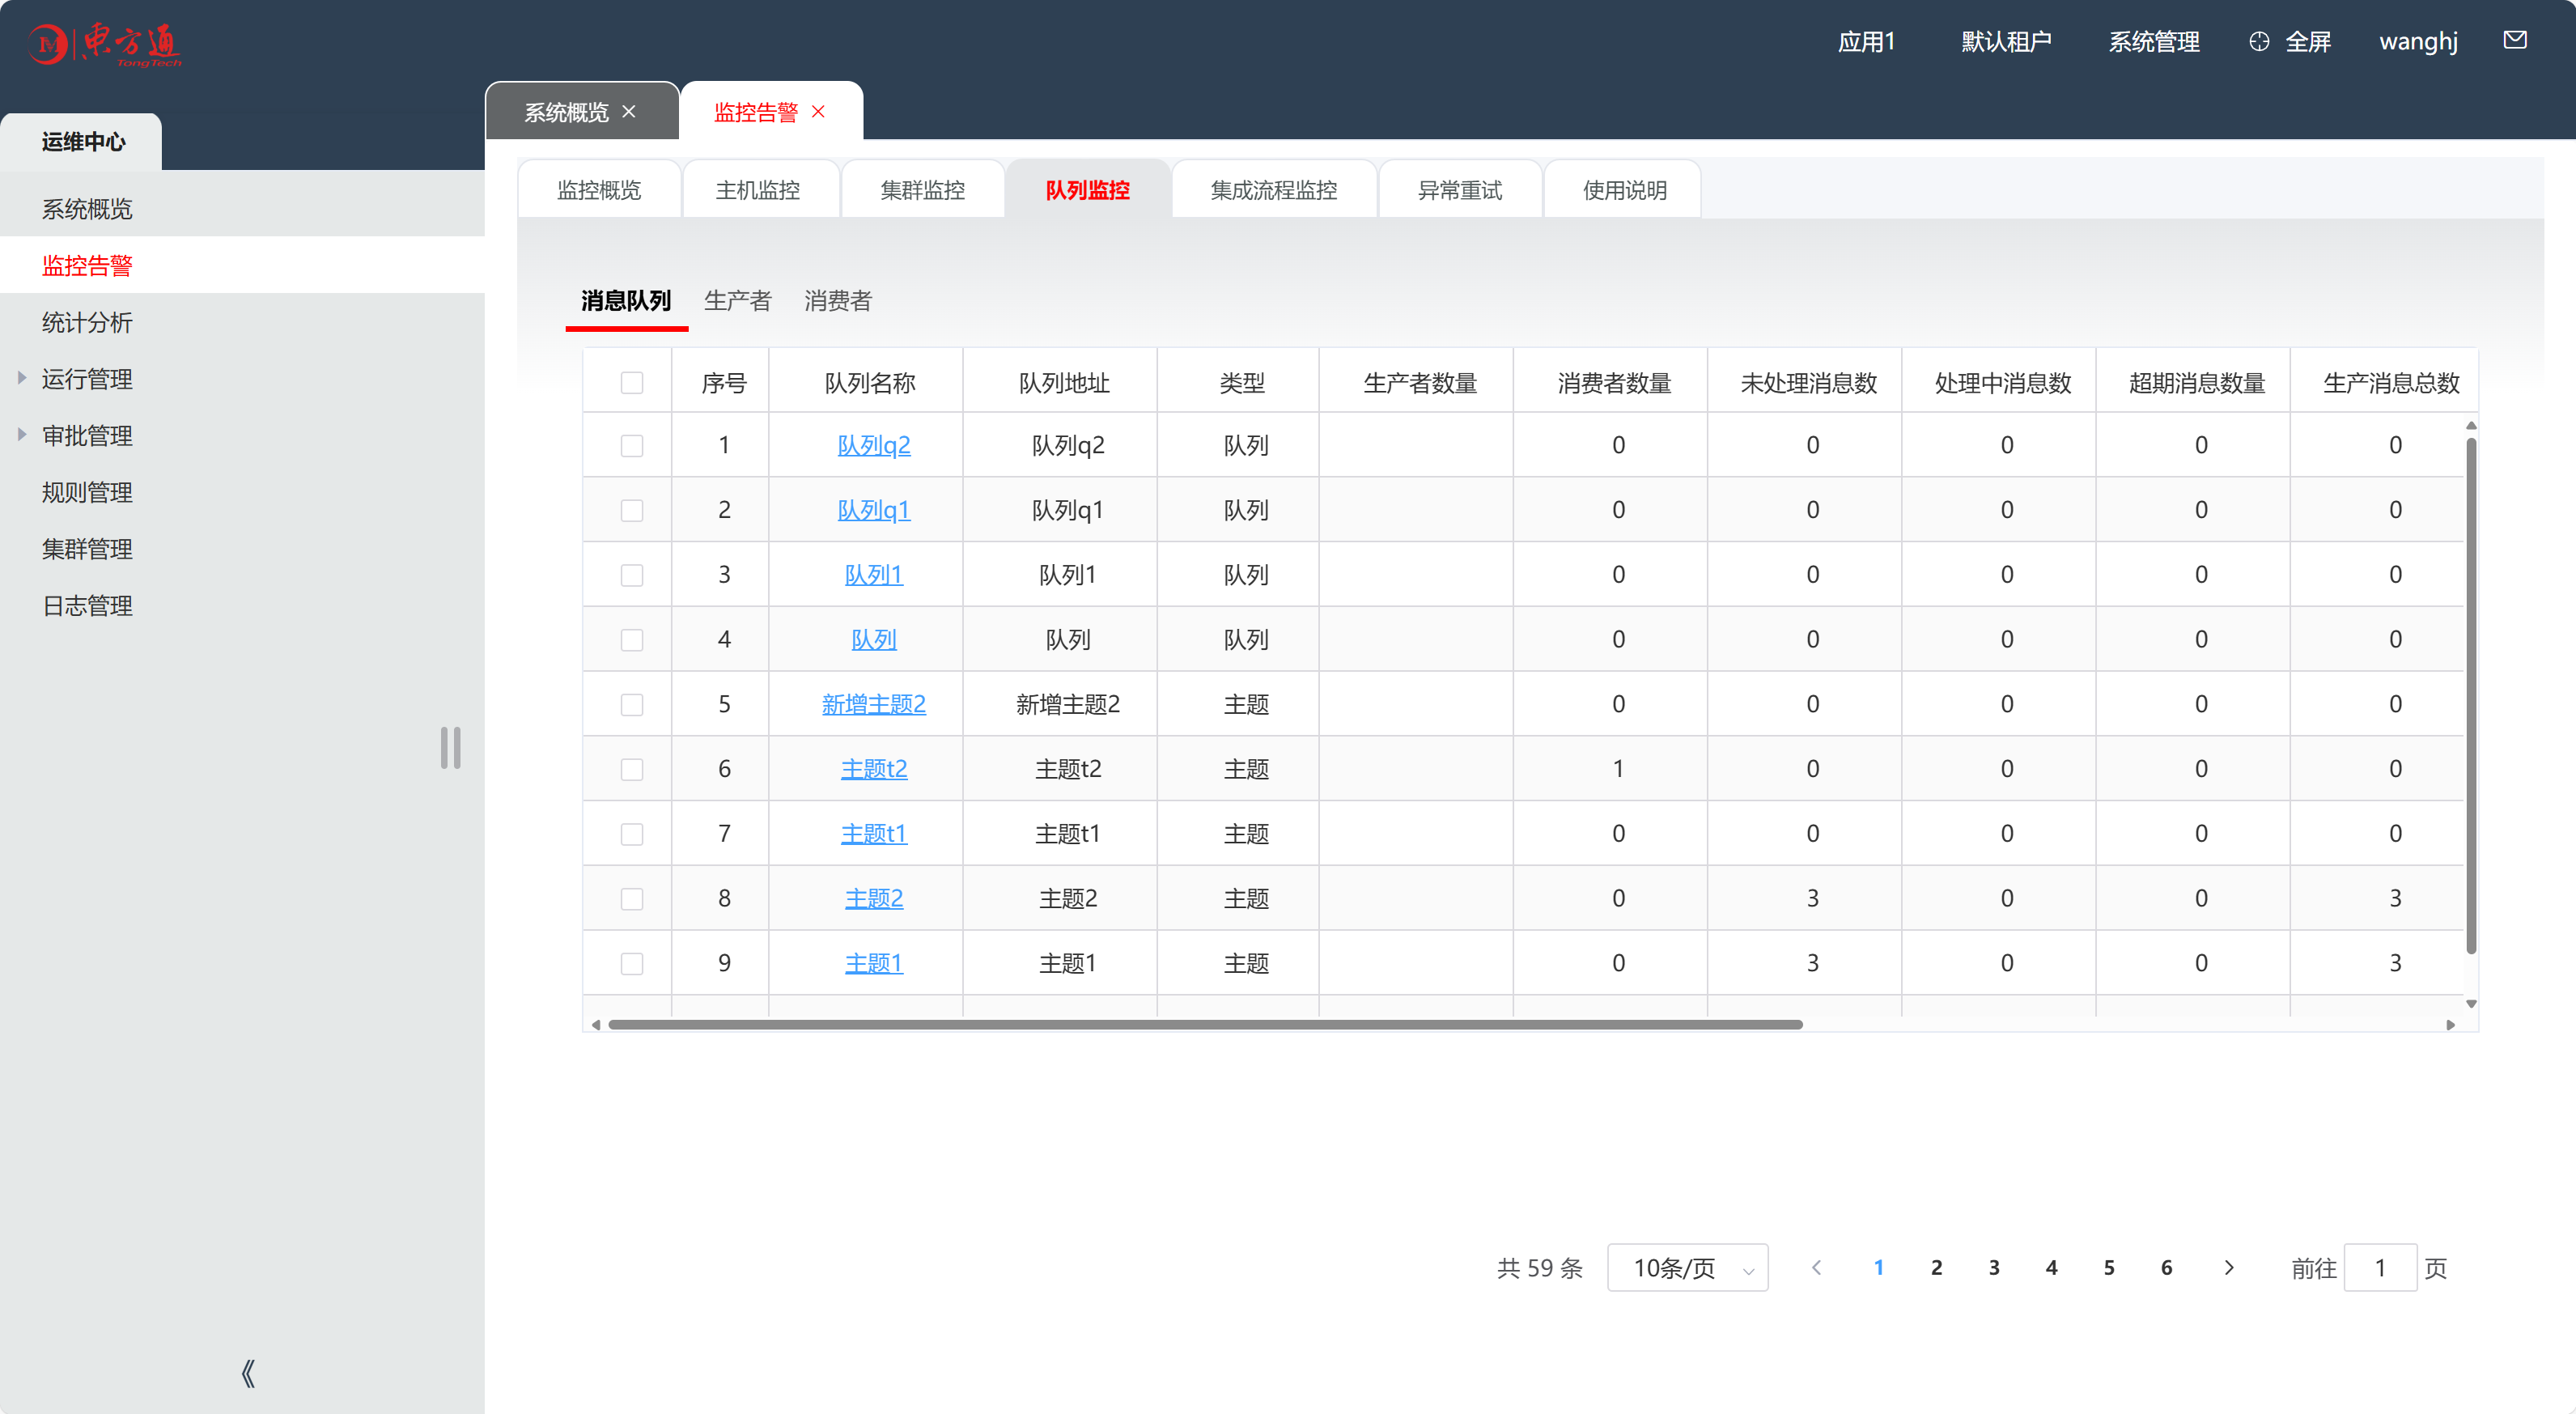
| 字段 | 说明 |
|---|---|
| 队列名称 | 队列唯一标识,用于区分不同消息通道 |
| 队列地址 | 网络访问地址,支持地址溯源 |
| 类型 | 分为 "主题(Topic)" 或 "队列(Queue)",对应发布订阅 / 点对点模式 |
| 生产者数量 | 实时发送消息的客户端数量 |
| 消费者数量 | 实时接收消息的客户端数量,显著低于生产者时易导致消息积压 |
| 未处理消息数 | 队列中待消费的消息总量,持续增长需排查消费者处理能力 |
| 处理中消息数 | 正在被消费的消息数量,用于评估实时处理效率 |
| 超期消息数量 | 超过预设超时时间未处理的消息,超期量过高需检查网络或消费者故障 |
| 生产消息总数 | 该队列自创建以来累计生产的消息总量,用于统计业务消息的产生规模。 |
| 消费消息总数 | 该队列自创建以来累计被消费的消息总量,与生产消息总数对比可判断是否存在消息丢失情况。 |
| 连接名称 | 消费者连接队列时的标识名称,可用于追溯连接异常等问题。 |
| 流程数量 | 与该队列相关联的流程数量,可反映队列在流程中的使用频次和重要程度。 |
- 生产者:作为实时发送 消息的客户端,呈现生产者名称、目标地址、协议、客户端 ID 及连接状态,助力定位消息发送端异常 。
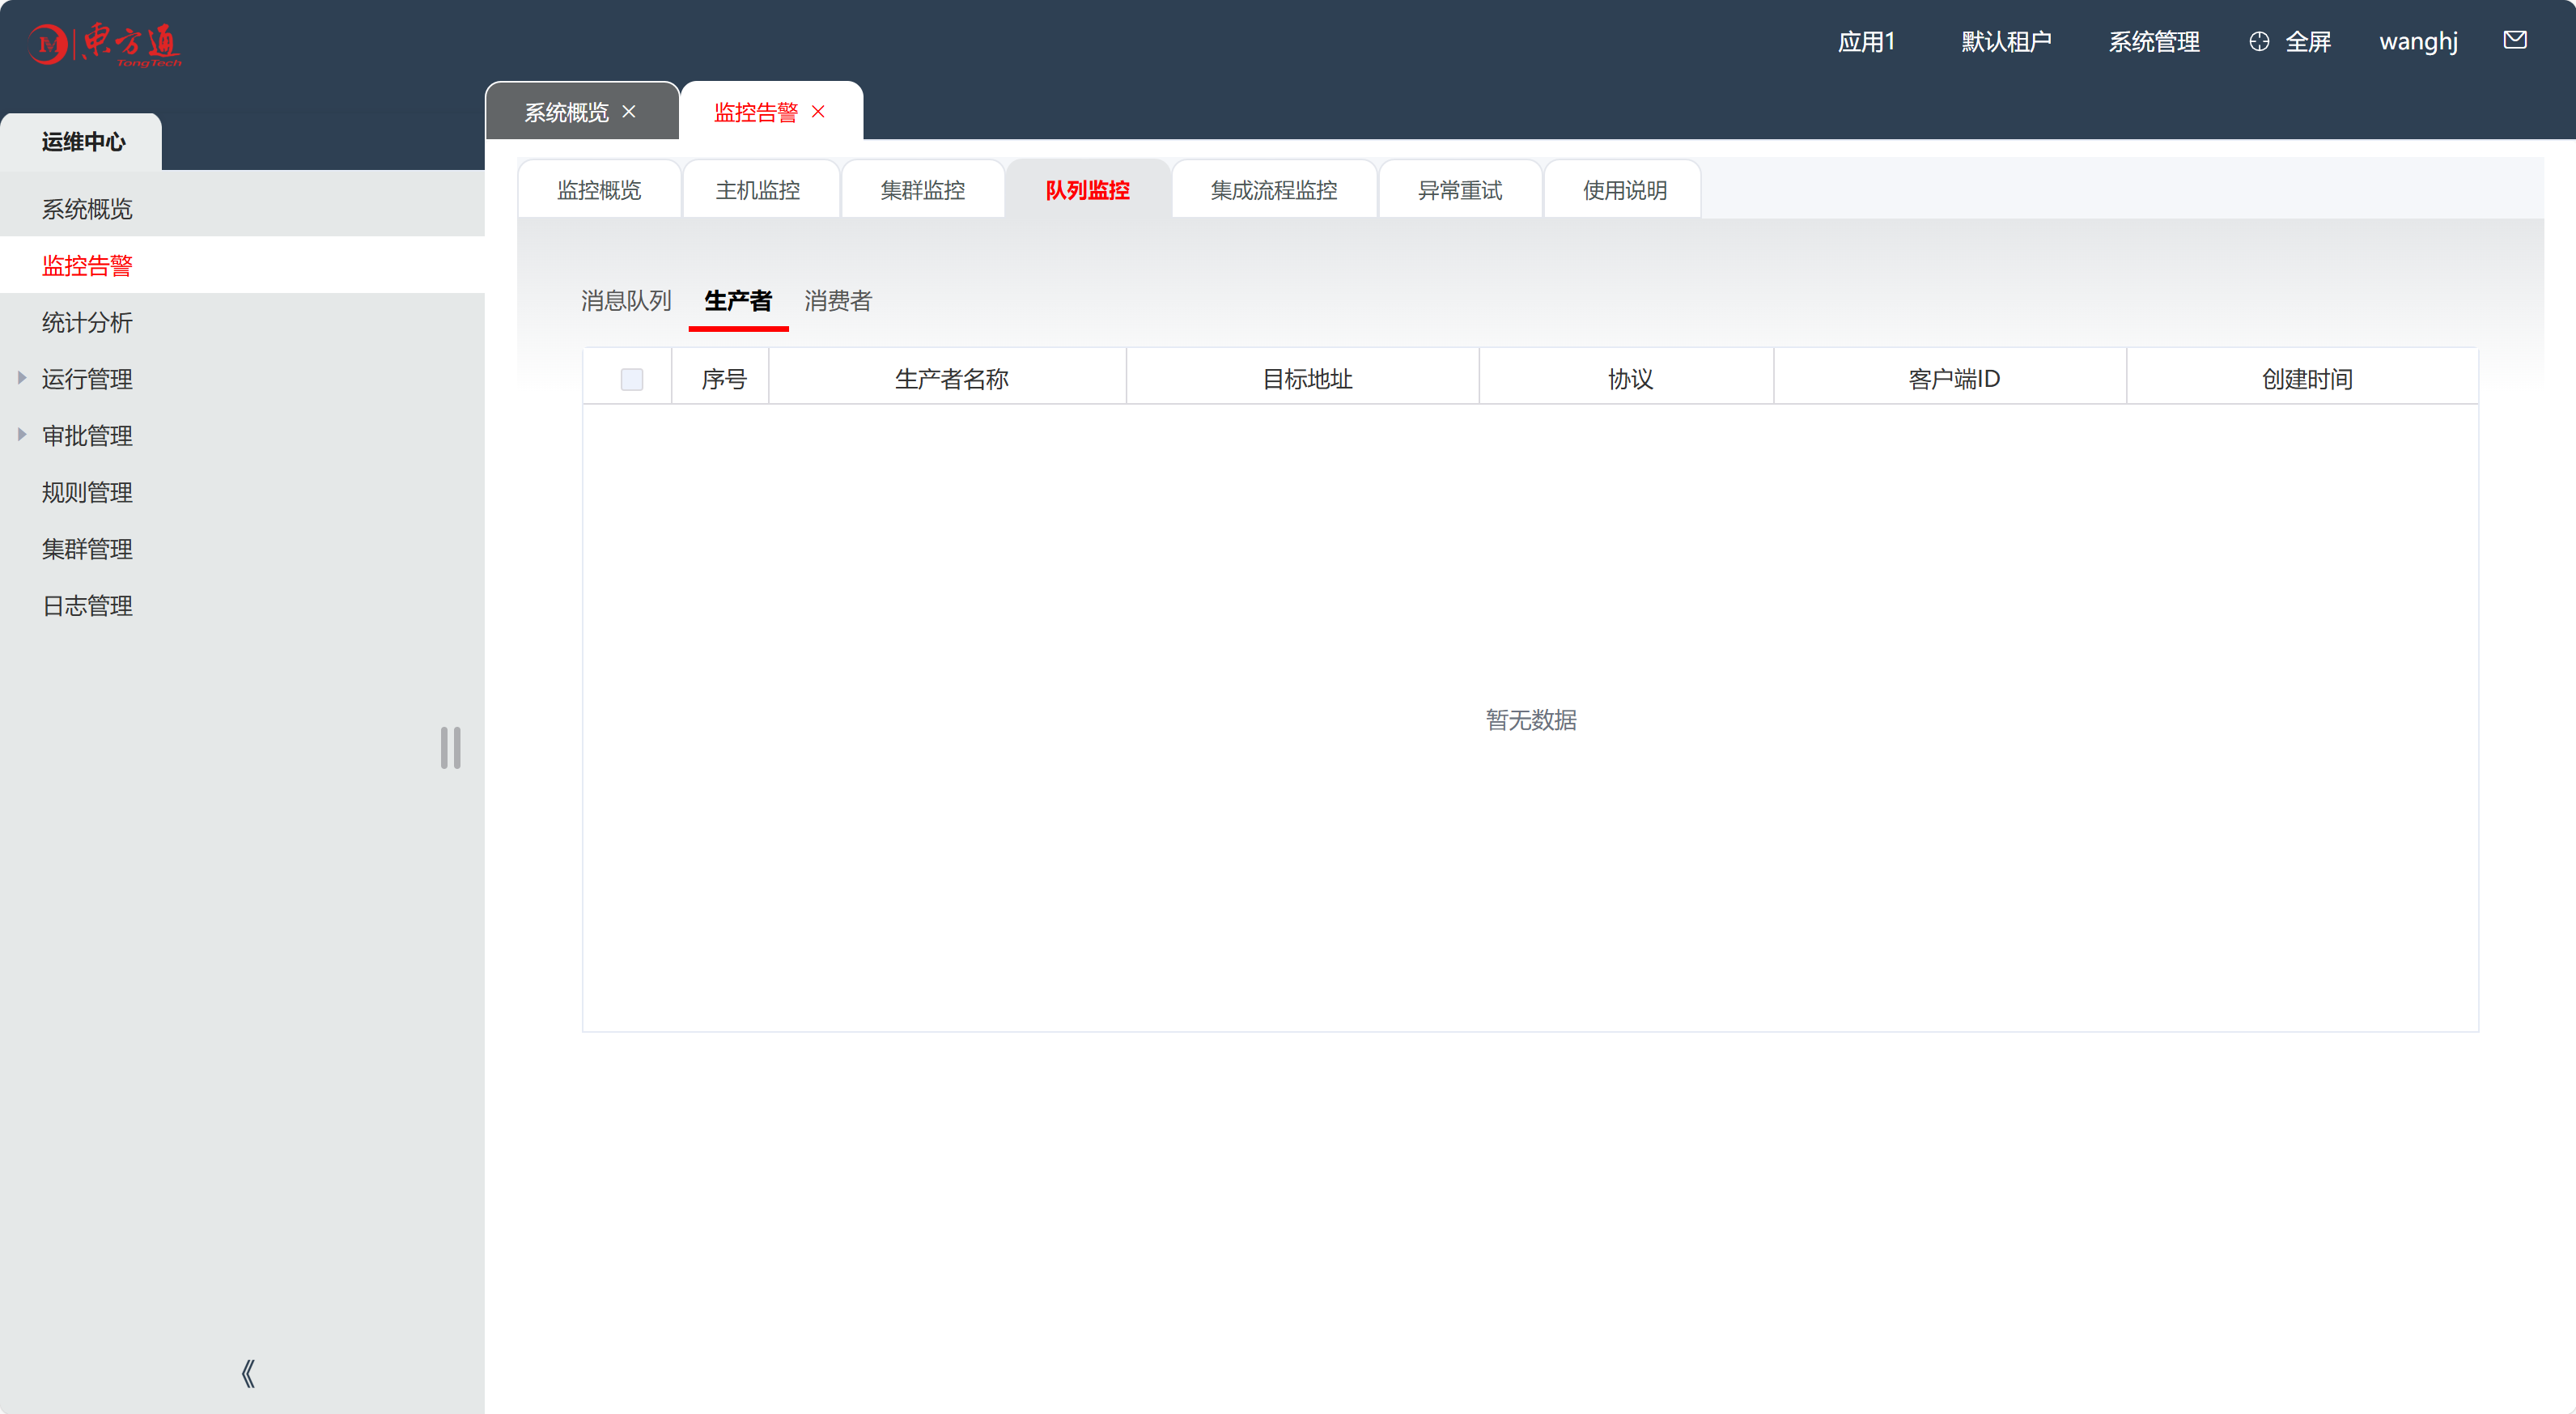
| 字段 | 说明 |
|---|---|
| 生产者名称 | 生产者实例唯一标识,通常关联业务模块名称 |
| 目标地址 | 生产者发送消息的目标队列或主题地址,用于确认消息的路由是否正确 |
| 协议 | 通信协议(如 AMQP),协议不匹配会导致发送失败 |
| 客户端 ID | 生产者唯一连接标识,用于追踪连接异常日志 |
- 消费者:作为实时接收 消息的客户端,显示消费者名称、订阅队列信息、远程地址、过滤器及消费速率,用于排查消息消费端问题。
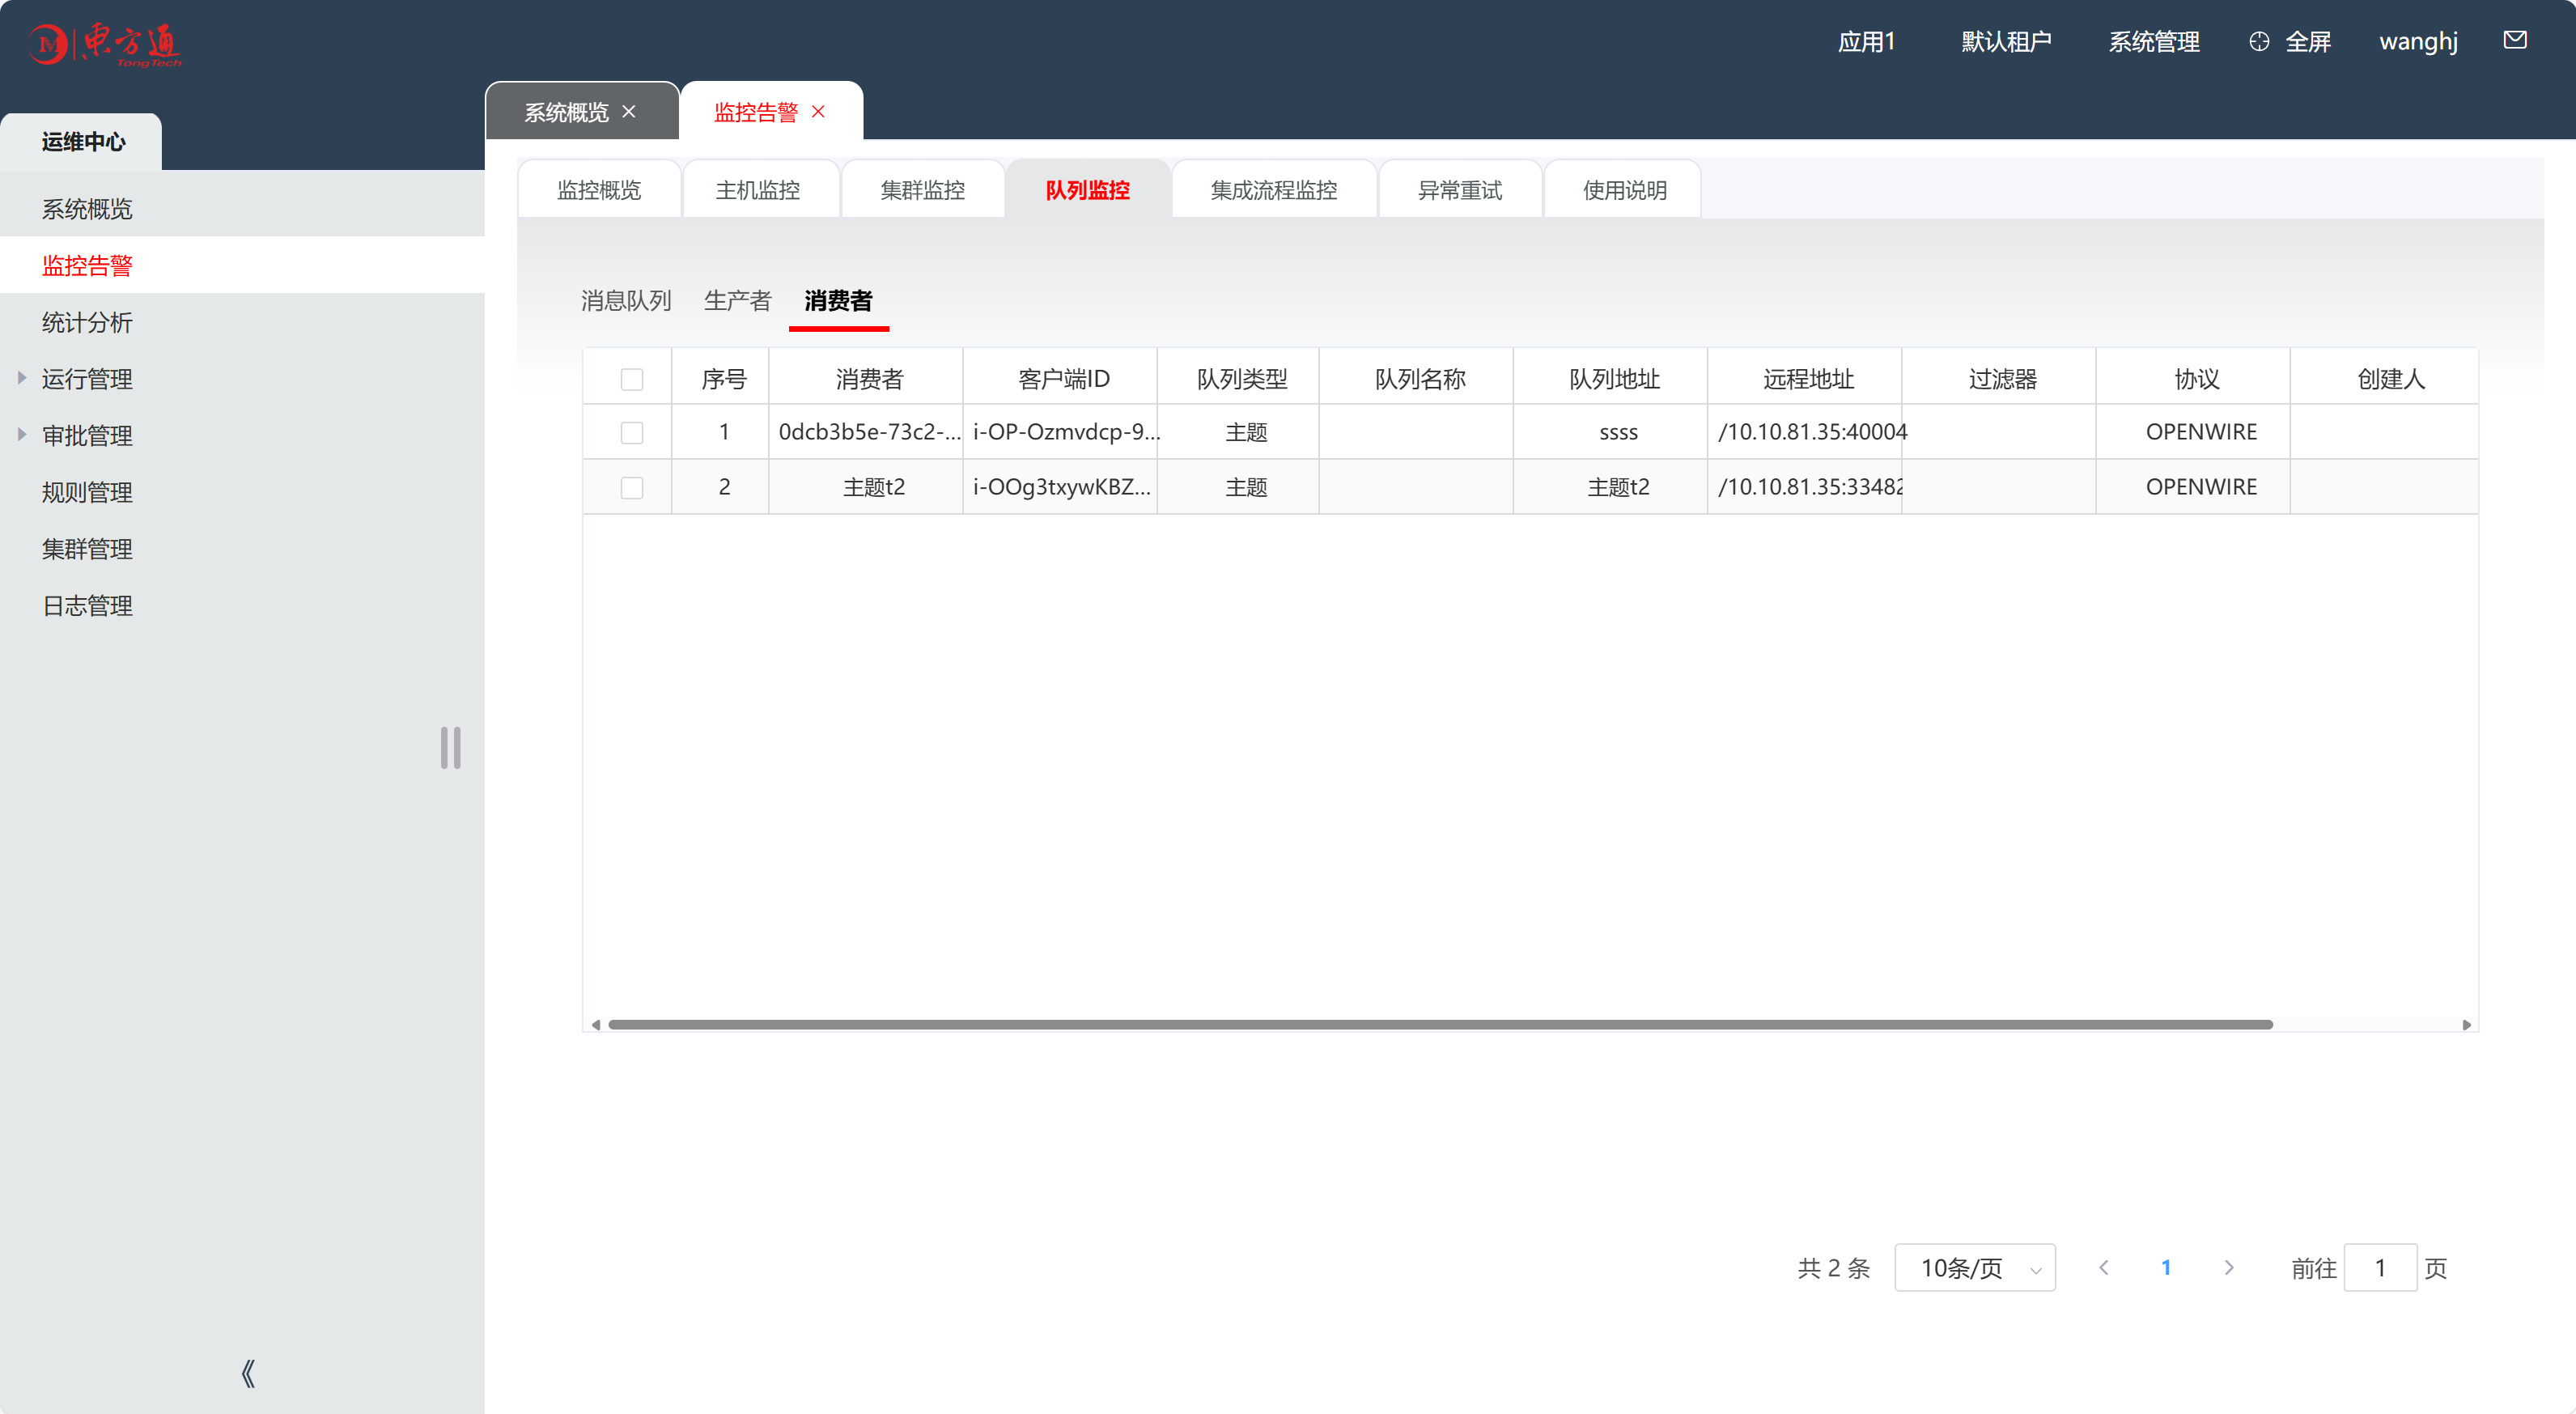
| 字段 | 说明 |
|---|---|
| 消费者 | 消费者实例标识,通常关联业务消费模块 |
| 客户端 ID | 消费者唯一连接标识,用于追踪消费异常日志 |
| 队列类型 | 订阅的队列类型(主题 / 队列),一般与生产者类型匹配 |
| 队列名称 | 订阅的目标队列 / 主题名称,用于确认消费链路正确性 |
| 队列地址 | 队列的网络访问地址,支持公网或内网地址,可用于地址溯源等 |
| 远程地址 | 消费者网络地址,用于排查网络延迟导致的消费超时等问题 |
| 过滤器 | 消息过滤条件,配置错误可能导致消息漏消费 |
| 协议 | 消费者与队列通信使用的协议,如 AMQP 等,协议不匹配会导致消息通信异常 |
(五)流程集成监控
集成流监控用于实时监测系统中各集成流的运行状态,提供关键性能指标数据,帮助及时发现并处理集成流异常。通过实时监测集成流的运行情况、请求成功率等关键指标,能够快速发现集成流运行过程中的异常情况,从而及时采取措施进行修复,保障业务流程的顺利进行。 在该页面,能直观看到各集成流的运行状态,通过不同颜色或图标区分成功和失败状态,便于快速识别异常集成流。页面还配备多种数据统计图表,助力深入分析集成流运行情况。
操作步骤:在左侧导航栏选择 "监控告警" ,顶部导航栏选择 "流程集成监控" 进入页面;可自定义 "近 1 小时""近 6 小时""近 12 小时""近 24 小时" 等时间范围查看数据。
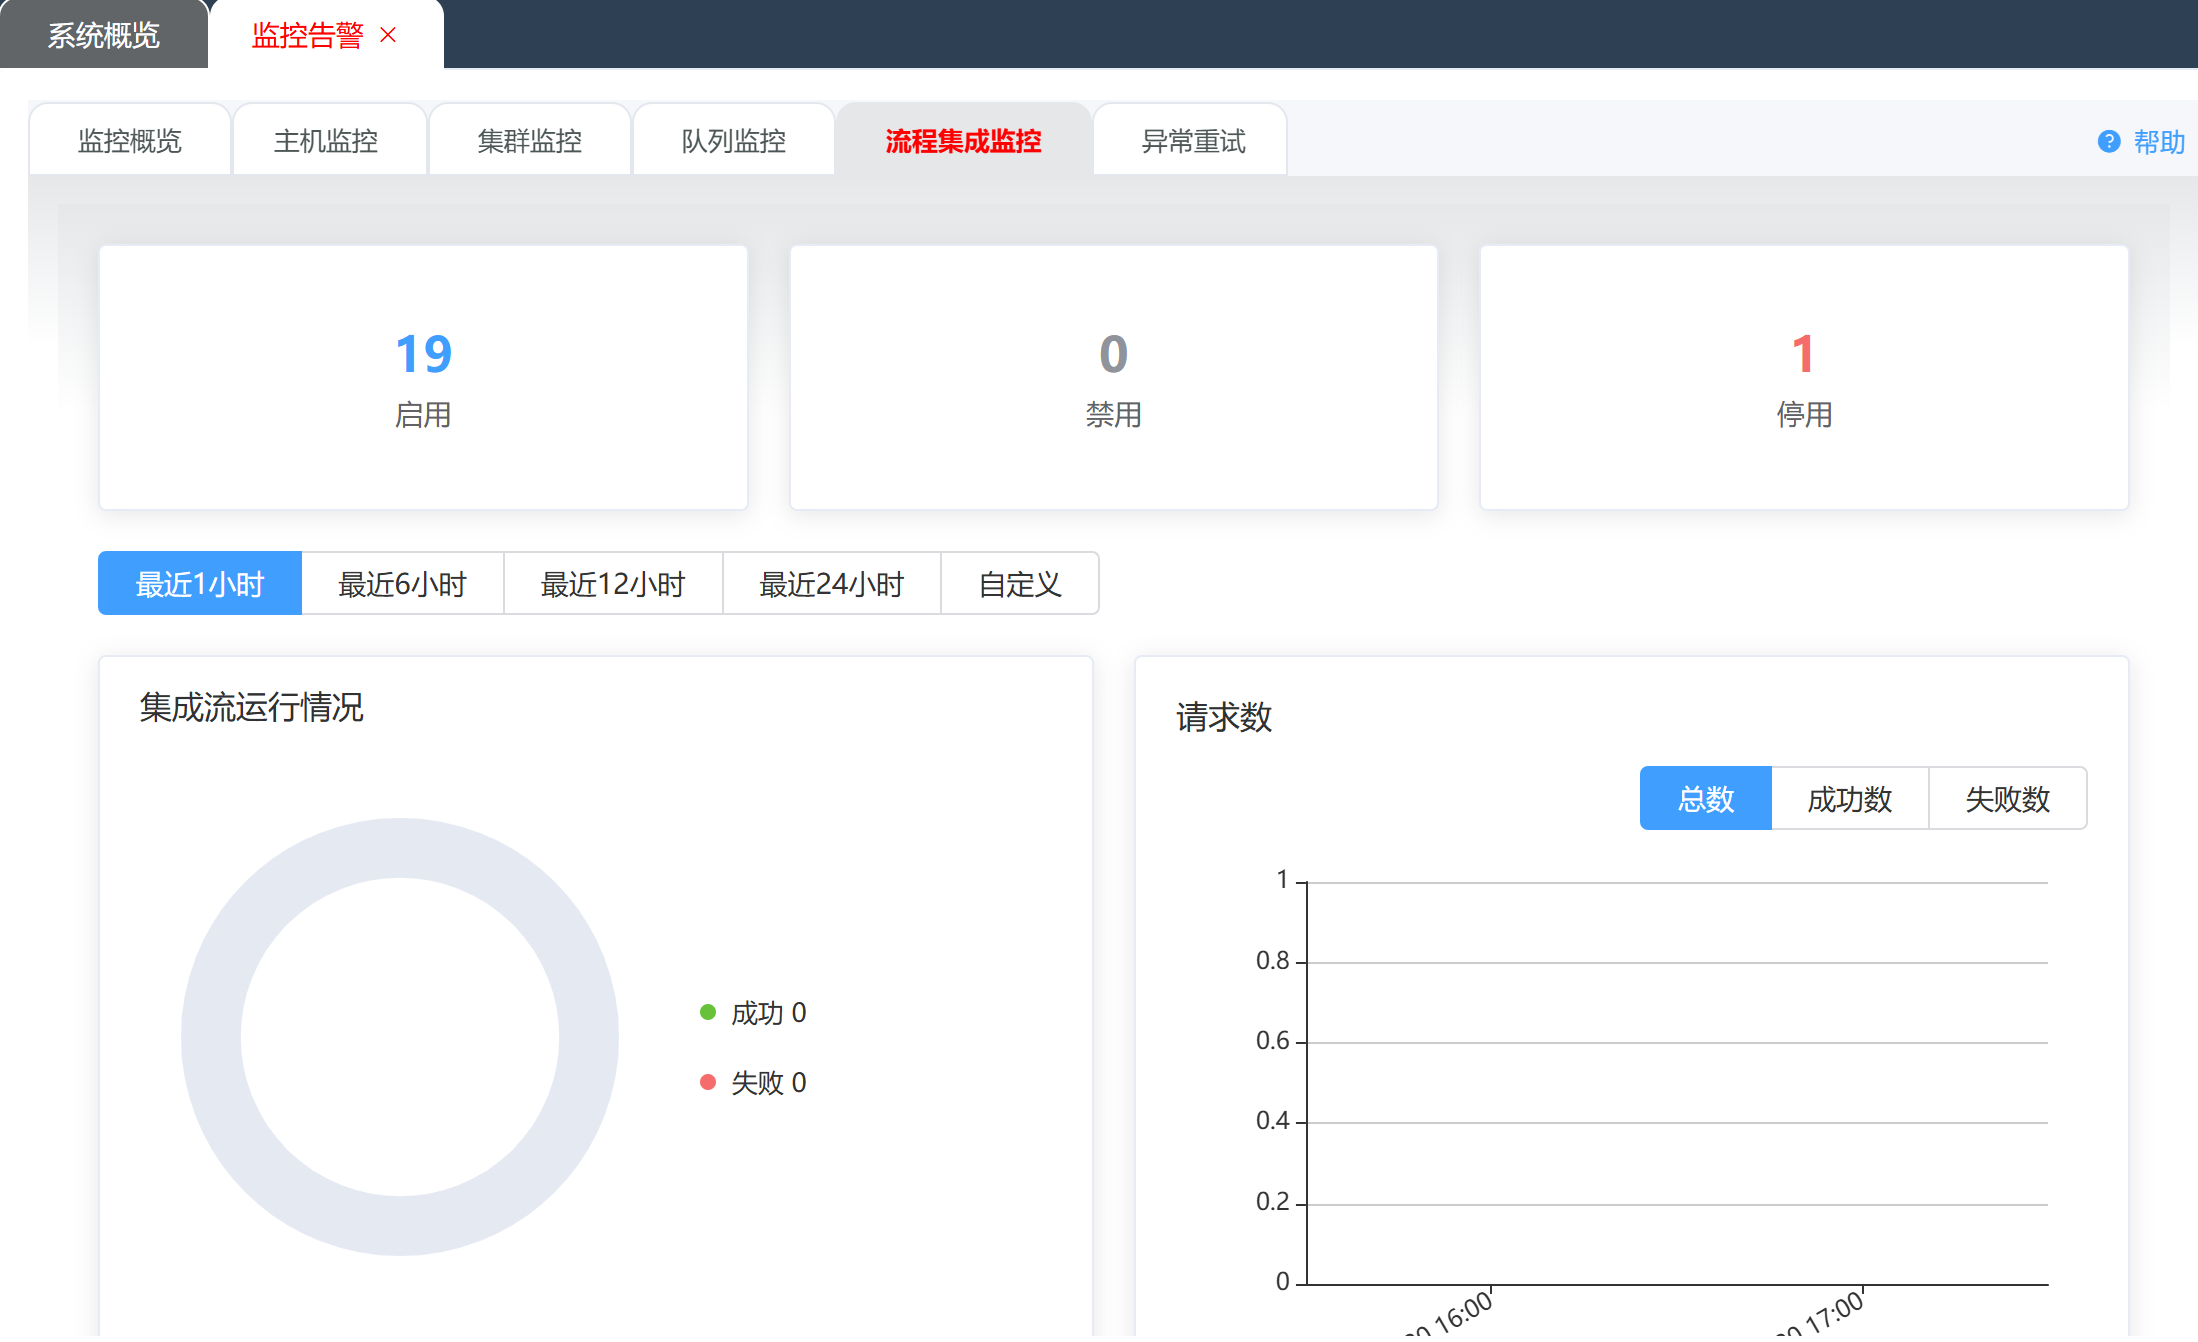
页面数据展示
-
集成流状态:以数字形式清晰展示 "正常""异常""停止" 三种状态的集成流数量。
-
集成流运行情况:通过图形界面区分集成流运行的成功(绿色标识)与失败(红色标识)状态,饼图展示所有集成流运行成功和失败的请求数量 。
-
请求数:通过柱状图展示请求总数、成功数和失败数,正常情况下请求成功率应高于 95%,失败率低于 5%,超出阈值需重点排查。
(六)异常重试
异常重试功能用于处理因网络波动、系统故障等导致的请求失败,确保业务流程连续性。
操作步骤:在左侧导航栏选择 "监控告警",顶部导航栏选择 "异常重试" 进入页面。
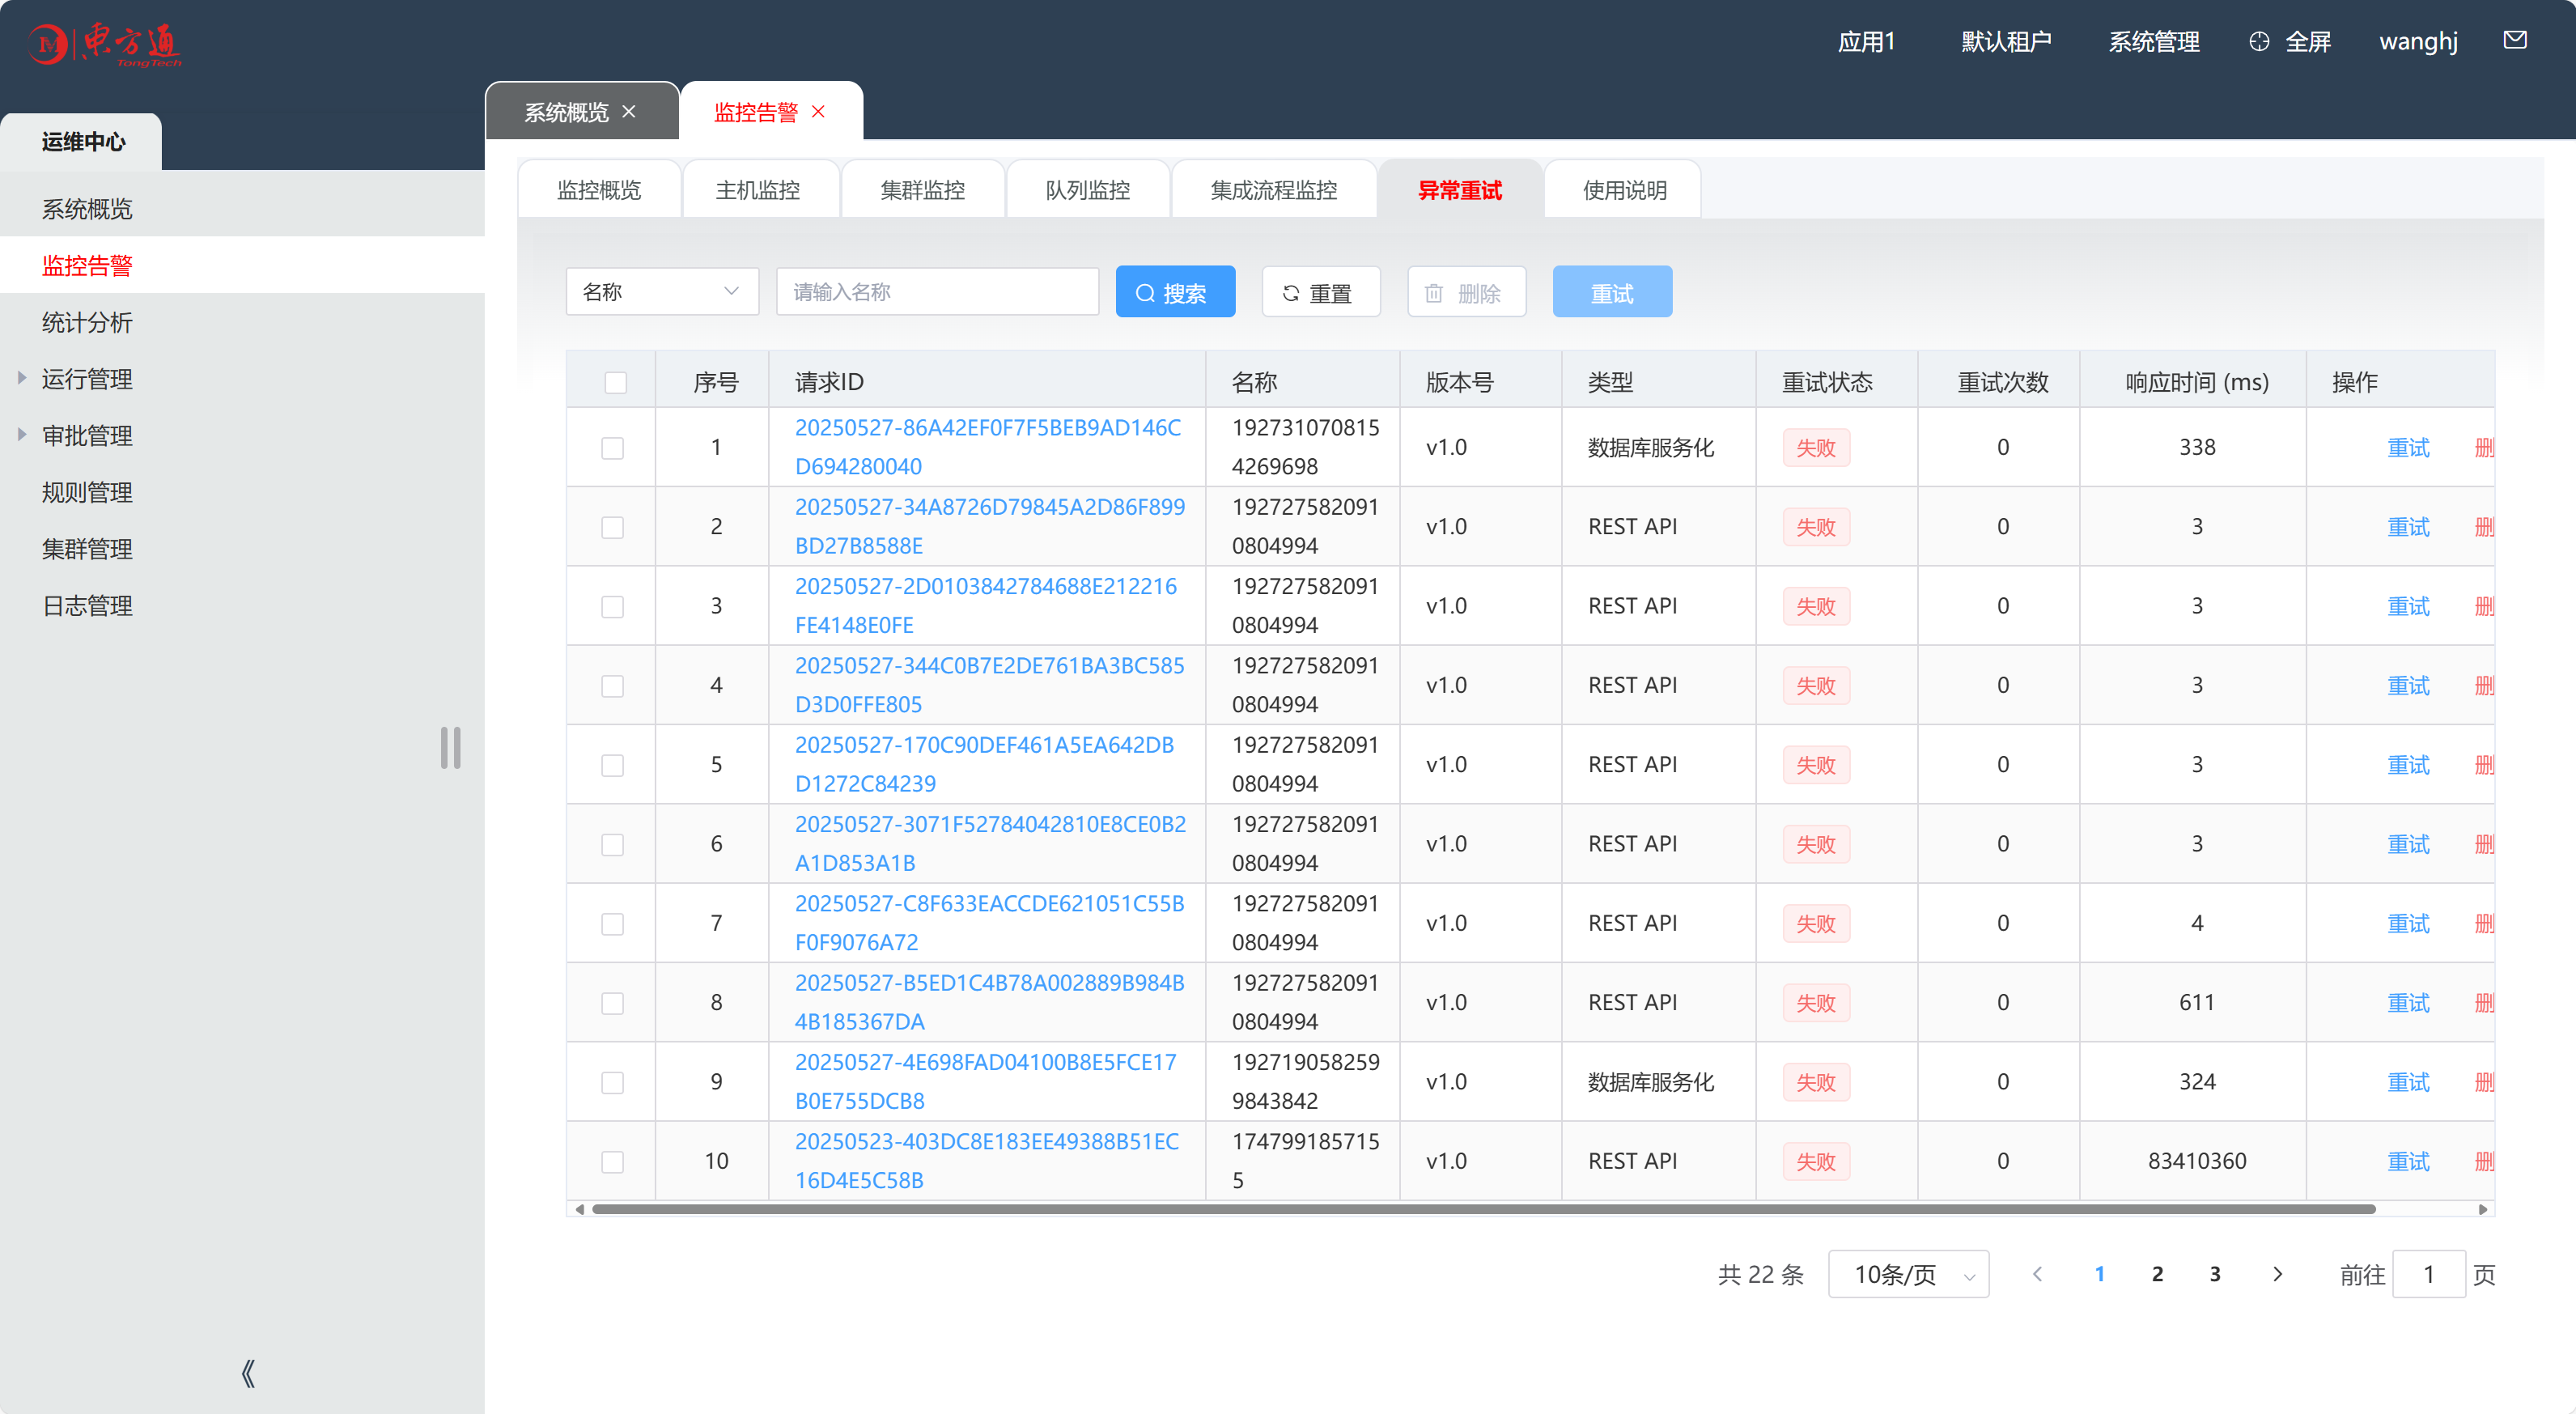
| 字段 | 说明 |
|---|---|
| 请求名称 | 队列唯一标识,用于区分不同消息通道 |
| 请求 ID | 记录异常请求的唯一标识,可用于追踪和定位具体的网络访问 |
| 名称 | 分为请求数据的名称 |
| 版本号 | 记录请求的版本号,用于区分不同版本请求 |
| 类型 | 记录数据的类型,分为"TIMER"、"REST API" 、"SOAP API"、"MQTT"、"KAFKA"、"JMS"、"SOCKET"、"EMAIL"、"HL7"、"AS2"、"CDC"、"HTTP简易代理"、"SOAP简易代理"、"SAP服务"、"数据库服务化" 16种类型。 |
| 重试状态 | 重试后的状态,分为 "成功" 、 "失败" |
| 重试次数 | 已重试的次数,超过阈值需重点排查 |
| 响应时间 | 以毫秒为单位的请求处理耗时 |
- 当点击表格中的请求 ID 时,可查看当前请求的详细信息
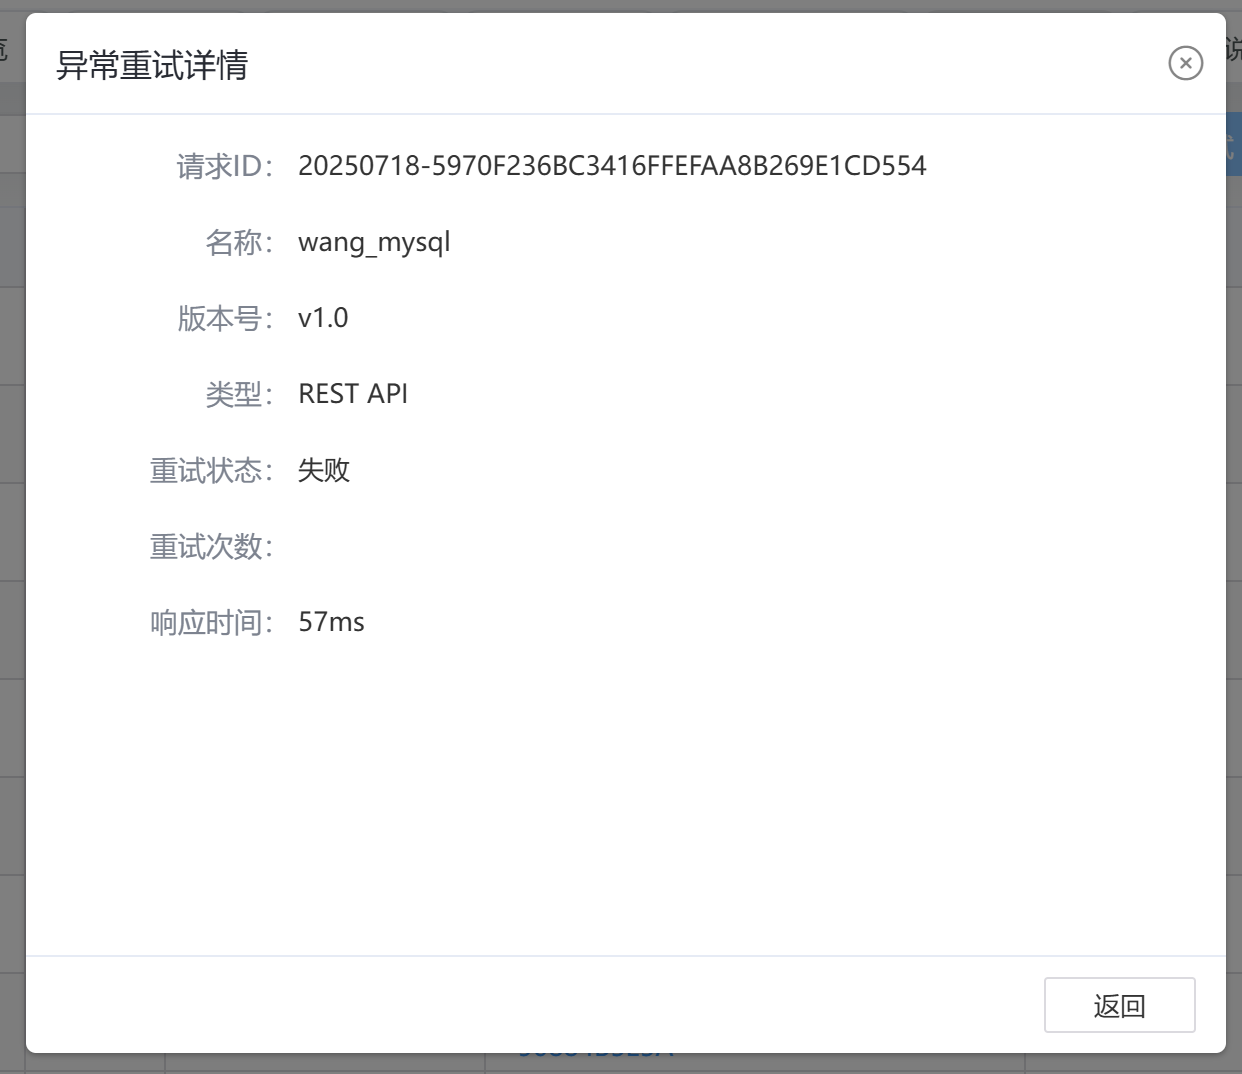
页面信息解读:以列表形式展示近期异常请求详情,包括请求 ID、名称、版本号、类型、重试状态、重试次数、响应时间及操作等信息,便于追溯问题、分析异常原因和优化系统。其中,请求 ID 作为每一条异常请求的唯一标识,可用于精准追溯;名称明确了请求所关联的业务内容或功能模块;版本号则有助于定位问题出现时对应的软件版本。类型字段详细区分了请求的类别。重试状态直观展示该请求是否进行过重试操作,是处于已重试成功、重试失败还是尚未重试的状态一目了然。重试次数记录了为解决异常而尝试重新发送请求的累计次数,便于分析异常的顽固程度。响应时间精确统计从发出请求到收到反馈的时长,单位通常为毫秒,这一数据对于评估系统性能和异常影响程度具有重要意义。
(七)事件网格
用于展示EventMesh端点的监控指标。
操作步骤:在左侧导航栏选择 "监控告警",顶部导航栏选择 "事件网格" 进入页面,
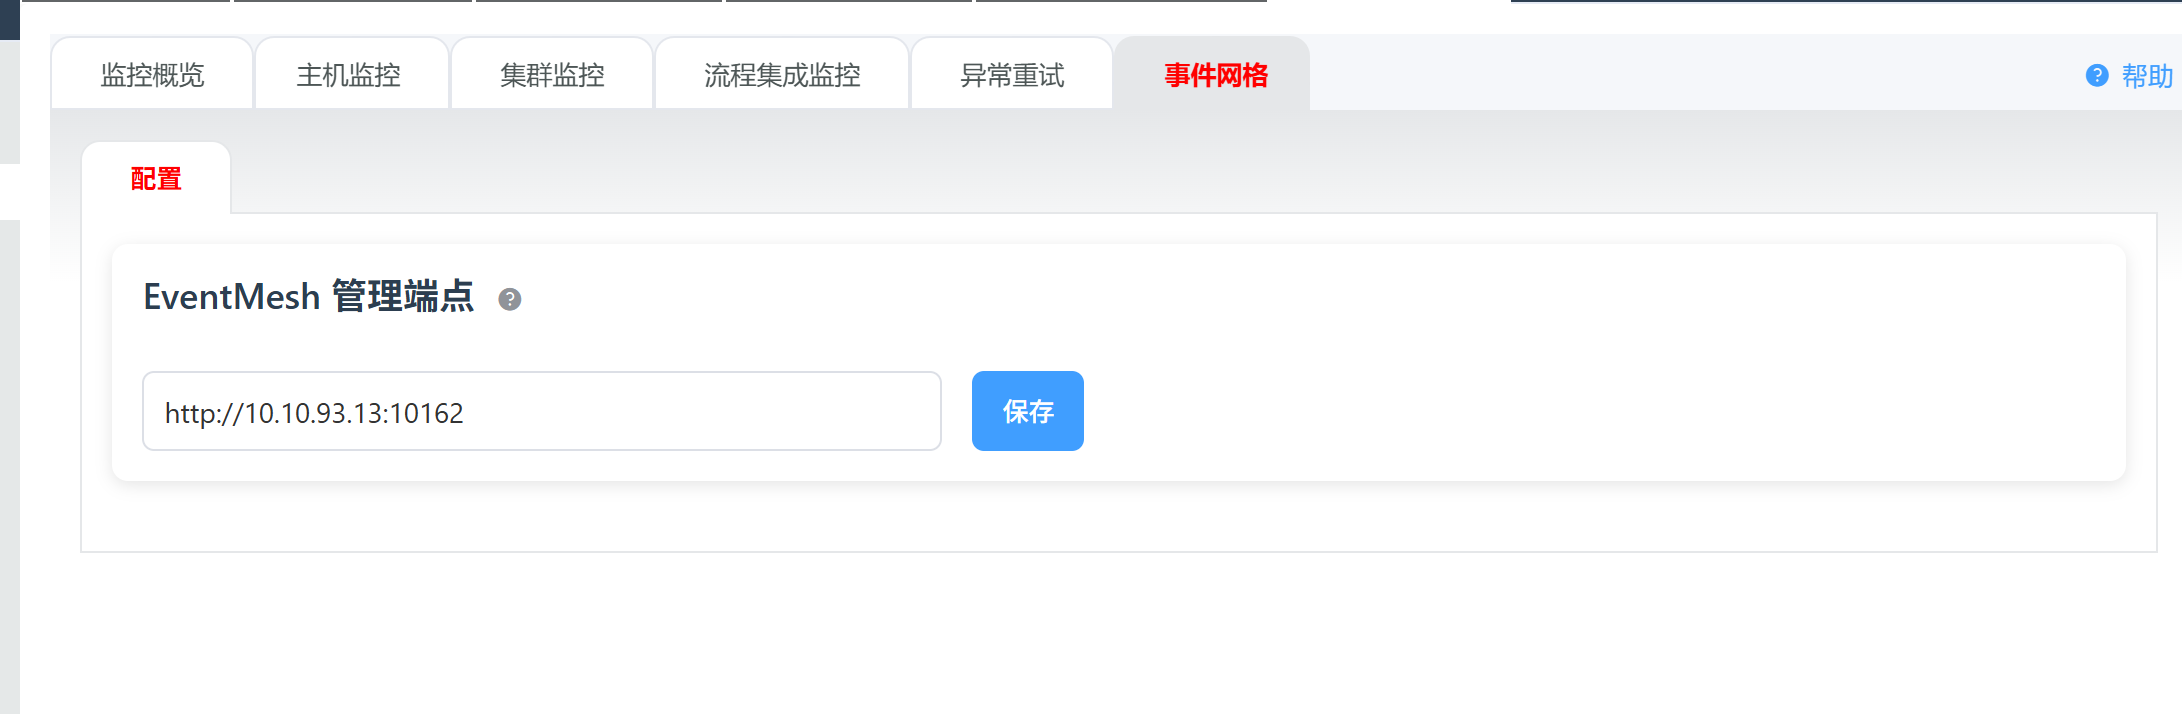
在配置页面输入要连接的EventMesh管理端点,点击“保存”按钮保存。连接成功后将在页面展示该端点的配置、指标信息。
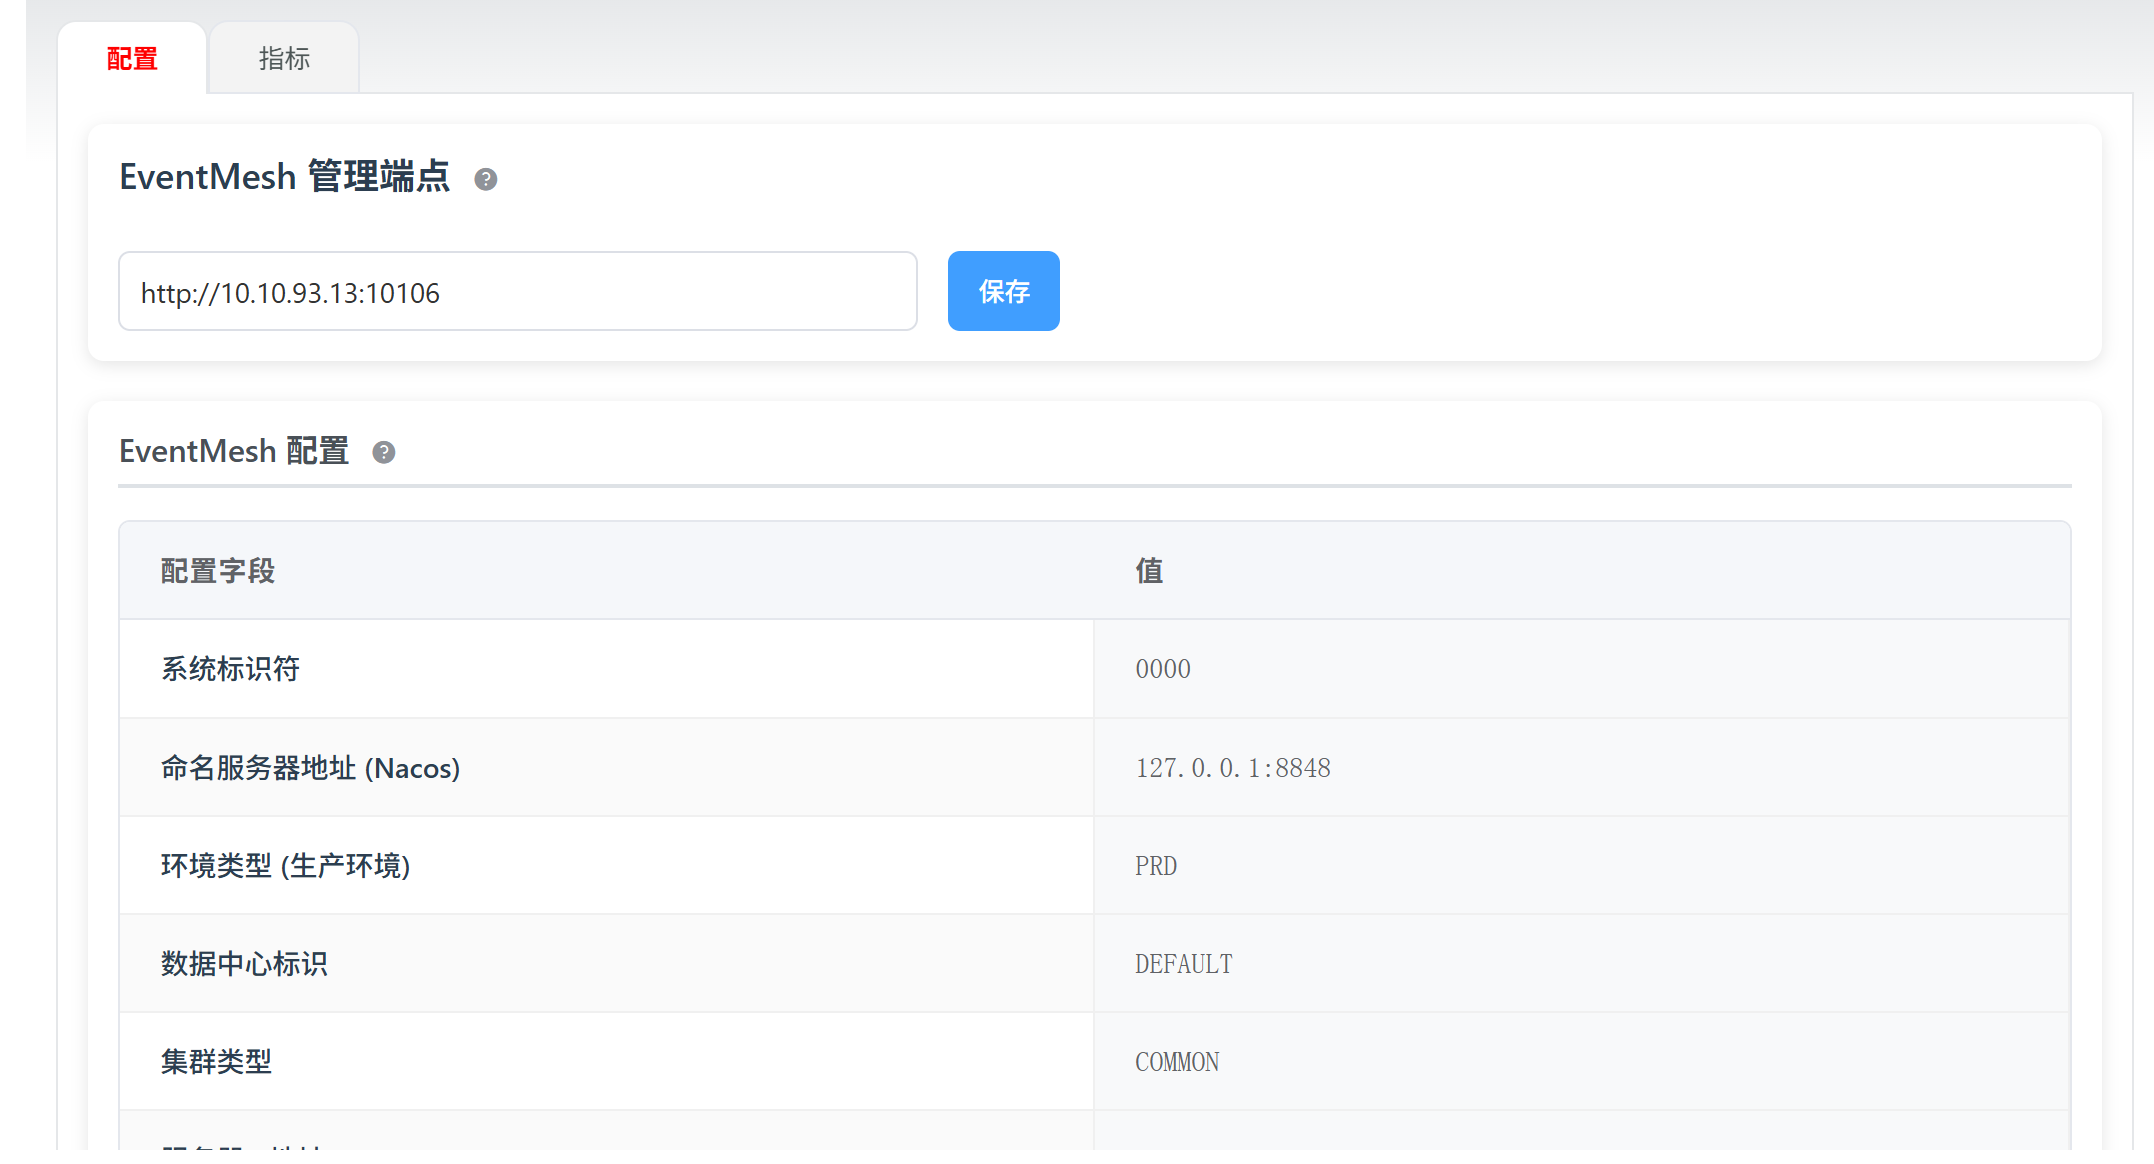
页面数据展示
- 配置:显示该端点的所有配置信息,包括TCP配置、HTTP配置、gRPC配置等信息。
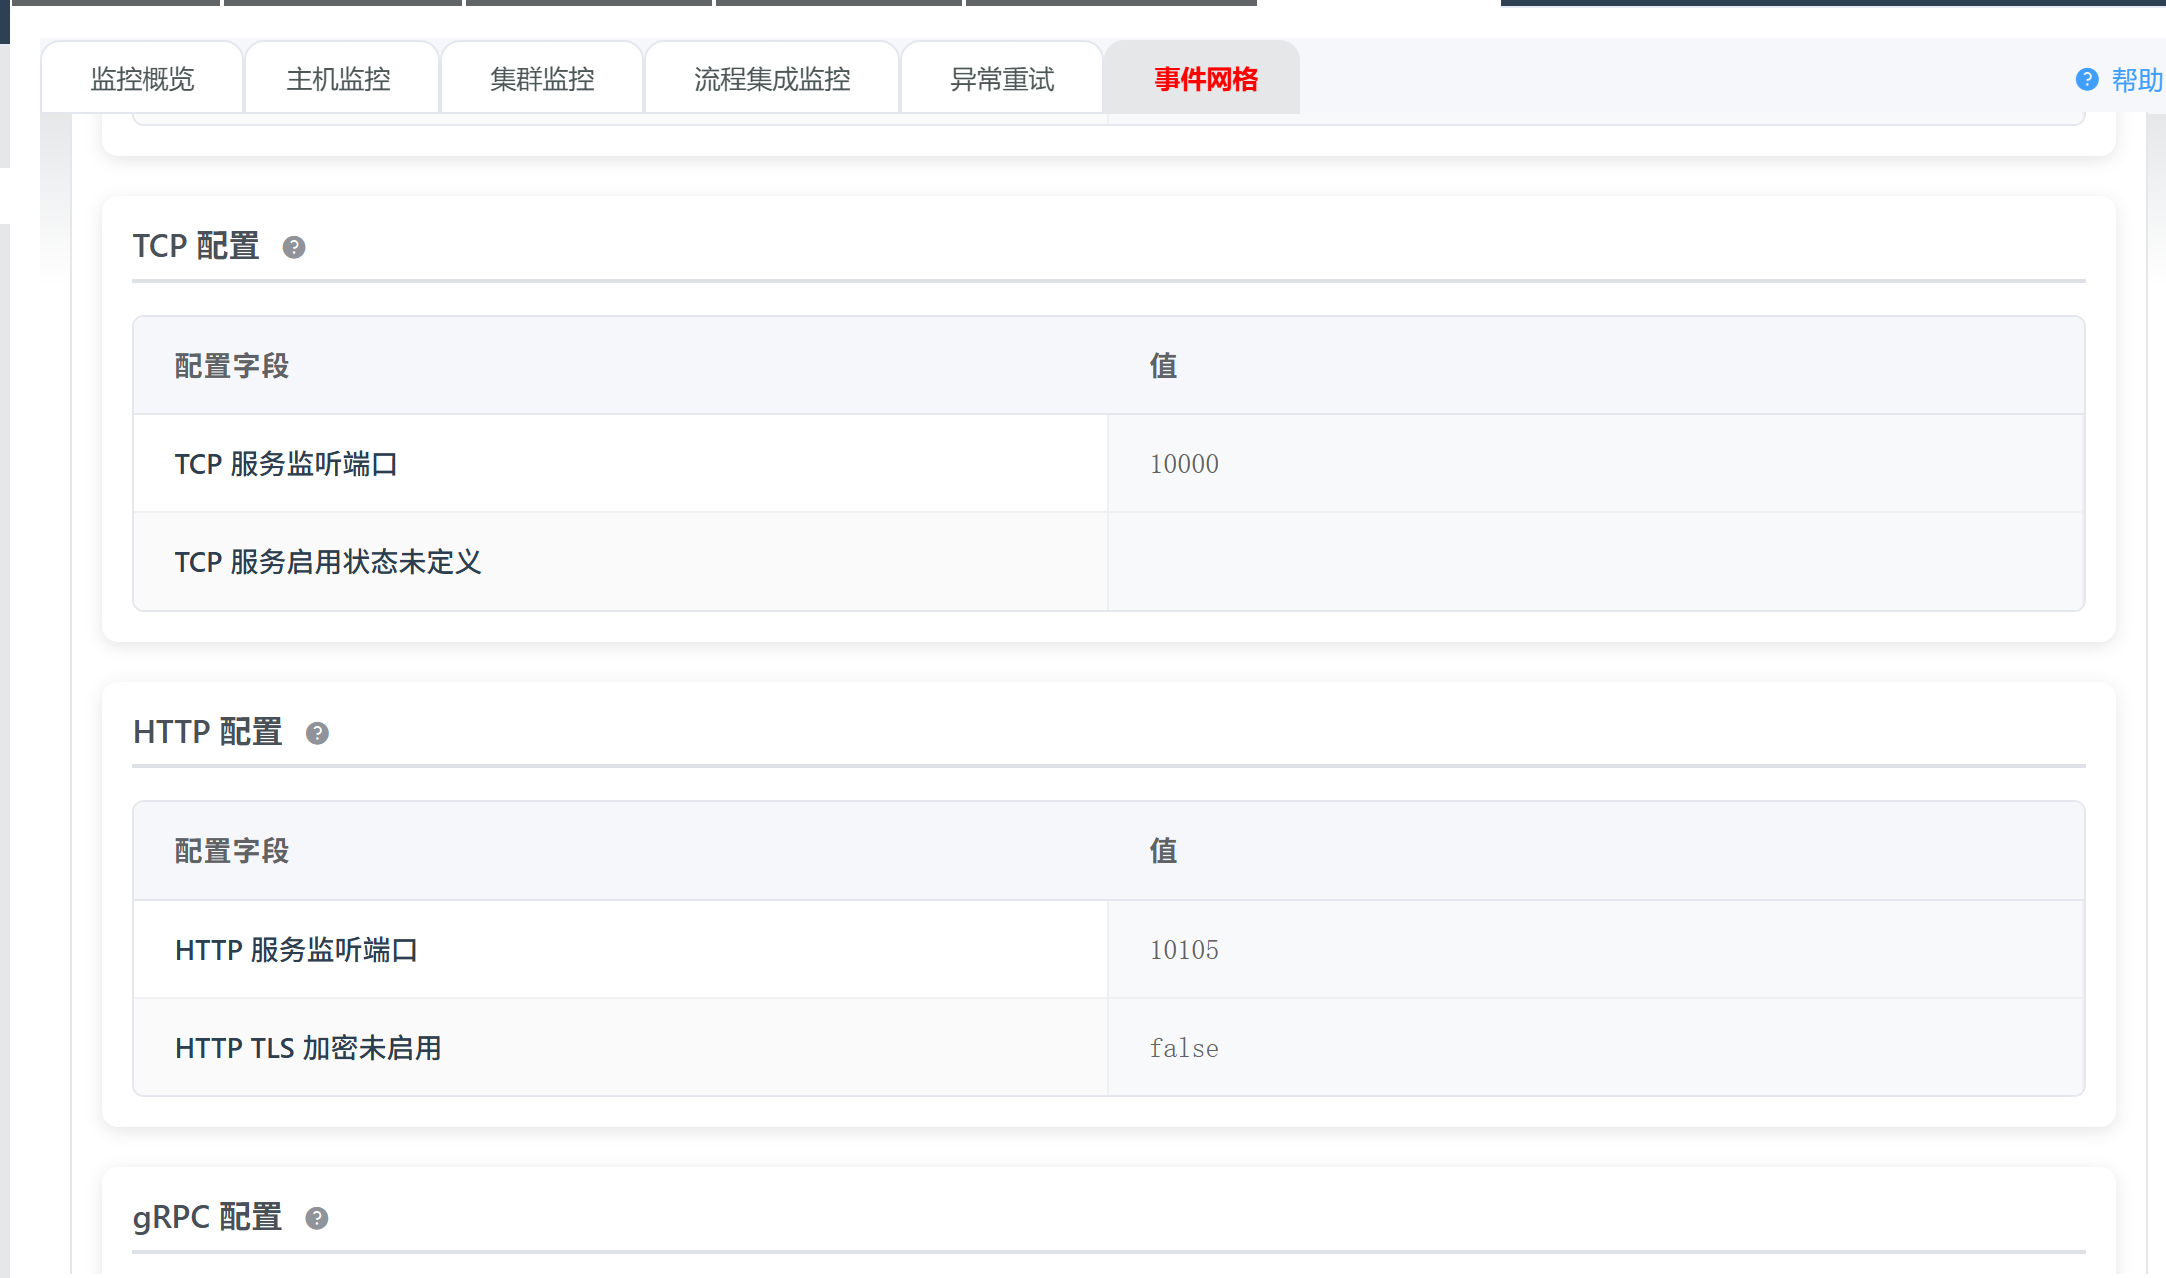
- 指标:显示该端点的所有指标信息,包括HTTP服务指标、HTTP批量处理指标、HTTP发送指标、HTTP推送指标、TCP指标分类等信息。
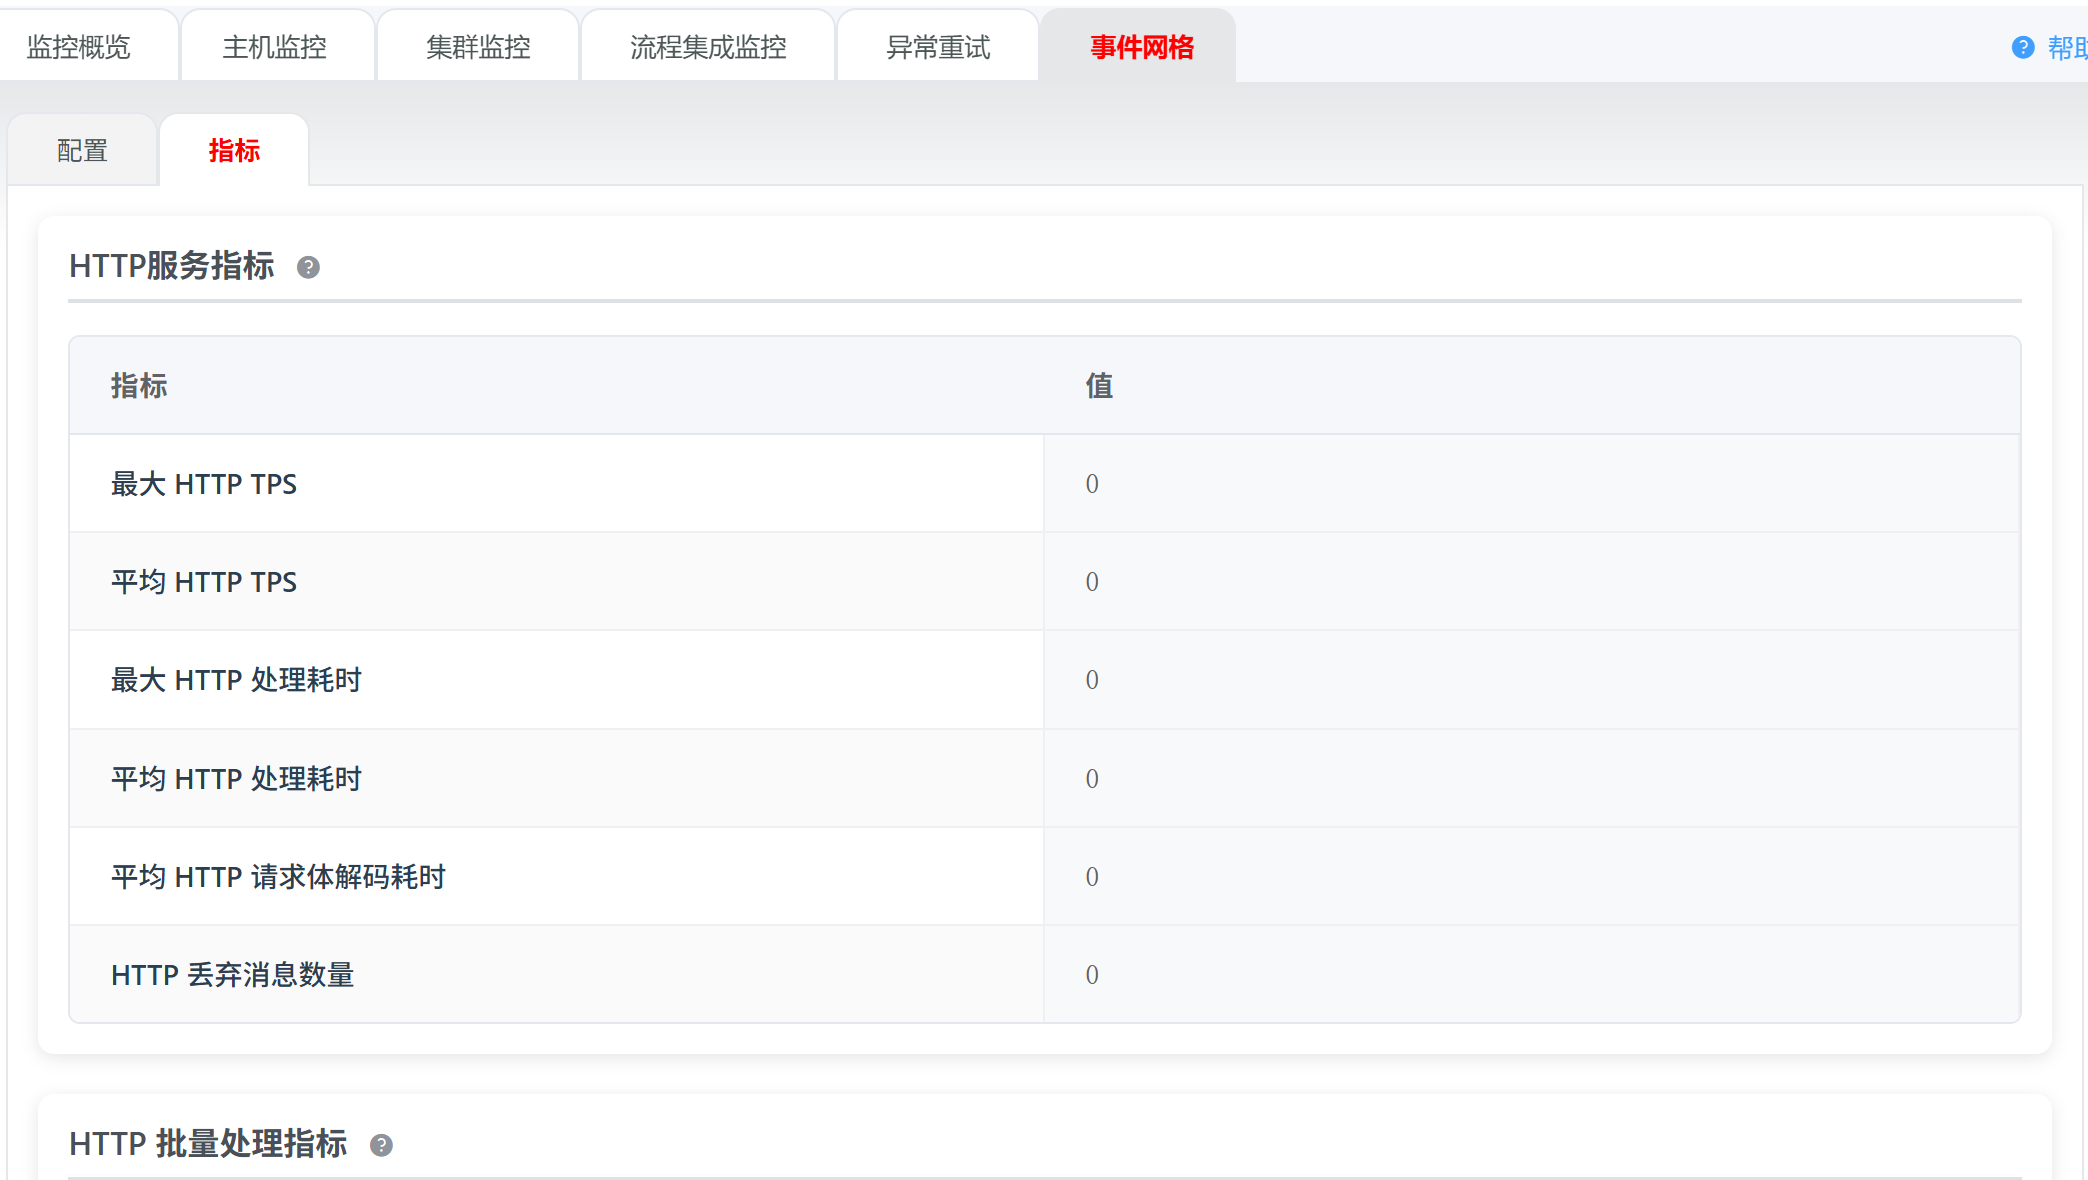
页面信息解读:以列表形式一目了然地展示EventMesh端点的配置、指标信息。
三、常见问题解答
(一)告警级别有哪些分类?
-
告警总数:当前系统所有级别的告警数量总和。
-
紧急总数:标记为紧急的告警,如服务器宕机、网络中断等需立即处理的严重问题。
-
重要总数:标记为重要的告警,包括资源使用率过高、服务响应超时等需及时关注处理的问题。
-
一般总数:标记为一般的告警,例如日志文件过大、配置文件更新等常规信息。
-
提示总数:标记为提示的告警,通常是系统更新通知、配置建议等无需紧急处理的信息。
(二)在使用主机监控功能时,如何根据监控数据优化系统性能?
当 CPU 使用率、内存使用率、磁盘读写速率或网络速率接近或超过系统设计上限且持续较长时间,可能存在性能瓶颈。如 CPU 使用率长时间超 80%,可考虑升级 CPU 或优化任务;内存使用率接近 100%,需增加内存容量。同时结合磁盘和网络监控数据,排查 I/O 瓶颈或网络带宽不足问题,采取针对性优化措施。
(三)如何评估集群运行状态?
-
节点状态分析:关注已启动和未启动节点数量,评估节点状态分布是否均衡。
-
集群健康度评估:考察服务可用性、负载均衡、数据同步状态和资源使用情况。
-
多集群比较分析:横向对比各集群运行状态,找出异常集群并分析差异原因。
-
后续行动判断:对健康集群维持常规监控,警告状态集群增加监控频率排查问题,异常集群立即进行排查修复。
(四)如何高效利用异常重试功能提升系统稳定性?
深入理解异常重试机制原理;利用请求 ID、名称等信息定位问题根源;关注重试次数和响应时间变化趋势,发现潜在性能瓶颈;根据异常类型和失败原因,合理调整重试次数和间隔,优化重试策略;结合系统日志综合分析异常重试信息,实现系统针对性优化。